
Представьте: API начал возвращать ошибки, и вы просите ИИ-помощника подсказать, с чего начать диагностику. Он может перечислить привычные шаги: проверить статус, заглянуть в журнал, посмотреть зависимости. Дальше всё делаете вы.
А теперь немного изменим задачу. У помощника есть доступ к двум разрешённым функциям: одна сообщает состояние сервиса, другая выдаёт инструкцию по диагностике. Система сама решает, какую функцию вызвать первой и нужна ли вторая после получения ответа. Вы видите уже не только совет, но и результаты выполненных проверок.
На этом примере удобно понять, что называют AI-агентом: как он получает информацию, выбирает следующий шаг и почему даже уверенное заключение модели ещё не означает, что проблема решена. Сравним агентов с чат-ботами и обычной автоматизацией, затем разберём небольшой пример на Python. Он обойдётся без внешней языковой модели — это позволит отдельно проверить сам механизм.
Что такое AI-агент
В программировании слово «агент» встречалось задолго до современных языковых моделей. Здесь речь о LLM-агентах — системах, в которых большая языковая модель (Large Language Model, LLM) участвует в выборе действий для выполнения задачи.
AI-агент использует модель, чтобы выбирать следующий шаг выполнения задачи, а инструменты — чтобы получать данные или выполнять разрешённые действия. В руководстве OpenAI основу такой системы описывают через модель, инструменты и инструкции.
Вернёмся к нашему API. Цель — собрать сведения об ошибке и предложить следующую проверку. Модель получает описание доступных функций и выбирает действие. Например, она может запросить состояние сервиса. Исполнитель — обычный программный код — проверяет запрос, вызывает функцию и передаёт результат обратно модели. Результаты предыдущих действий становятся частью контекста, на который модель опирается дальше.
У каждого участника своя работа. Модель предлагает, что проверить. Функция получает данные. Исполнитель решает, разрешено ли выполнить запрос и как обработать ошибку. Если модель попросит инструмент, которого в программе нет, никакого действия происходить не должно.
Наконец, агенту нужны правила завершения: когда дать ответ, остановиться из-за ошибки или обратиться за решением к человеку. Отсутствие ручного управления каждым шагом не означает отсутствия ограничений.
AI-агент, чат-бот и обычный сценарий: в чём разница
Здесь легко запутаться, потому что сравниваются разные вещи. Чат-бот — это способ общения с системой. Агент — способ организовать выполнение задачи. Агент может отвечать через чат, а чат-бот может использовать инструменты и внутри оказаться агентной системой.
Полезнее сравнить не названия продуктов, а то, кто определяет последовательность действий. В заранее заданном процессе порядок шагов определяет программа; в агенте следующий шаг в допустимых границах выбирает модель. Именно так Anthropic различает процессы и агентов.
| Подход | Как выбирается следующий шаг | Что произойдёт при HTTP 503 |
|---|---|---|
| Чат-бот без инструментов | Модель составляет ответ из доступного ей контекста | Объяснит возможные причины и предложит проверки, но не запросит статус сервиса |
| Обычная автоматизация | Порядок и развилки заданы в коде | Выполнит предусмотренные программой проверки |
| LLM-агент | Модель выбирает действие из разрешённых с учётом новых данных | Может запросить статус, затем инструкцию или другой доступный источник |
Второй и третий варианты могут выглядеть для пользователя одинаково. Различие обнаружится внутри программы: один алгоритм следует прописанным условиям, другой передаёт модели выбор следующего действия. Несколько вызовов LLM подряд сами по себе ещё не превращают процесс в агента.
Представьте проверку, для которой всегда достаточно запросить два адреса и сравнить коды ответа. Привлекать модель к выбору этих двух действий, скорее всего, незачем. А если после каждого наблюдения нужно решить, где искать дальше, модель может быть полезна. Это не обещание, что агент обязательно справится лучше: за гибкость приходится платить дополнительными вызовами, временем и сложностью проверки.
Как работает AI-агент: от запроса к следующему действию
Допустим, вы сформулировали цель: «Узнайте, что происходит с api, и подскажите следующую проверку». Система знает две функции: get_status и get_runbook. Вторая возвращает инструкцию по диагностике — набор подсказок для известной ситуации.
Дальше выполнение может выглядеть так:
- Модель получает цель и описание инструментов. Она запрашивает
get_status(service="api"). - Программа проверяет название функции и значение аргумента
service, затем выполняет разрешённый вызов. - Инструмент возвращает
HTTP 503. Программа сохраняет наблюдение и передаёт его модели. - Увидев результат, модель может запросить
get_runbook(service="api")и получить рекомендацию проверить журнал и сервер, от которого зависит API. - Когда сведений достаточно для следующей рекомендации, система завершает цикл и формирует ответ человеку.
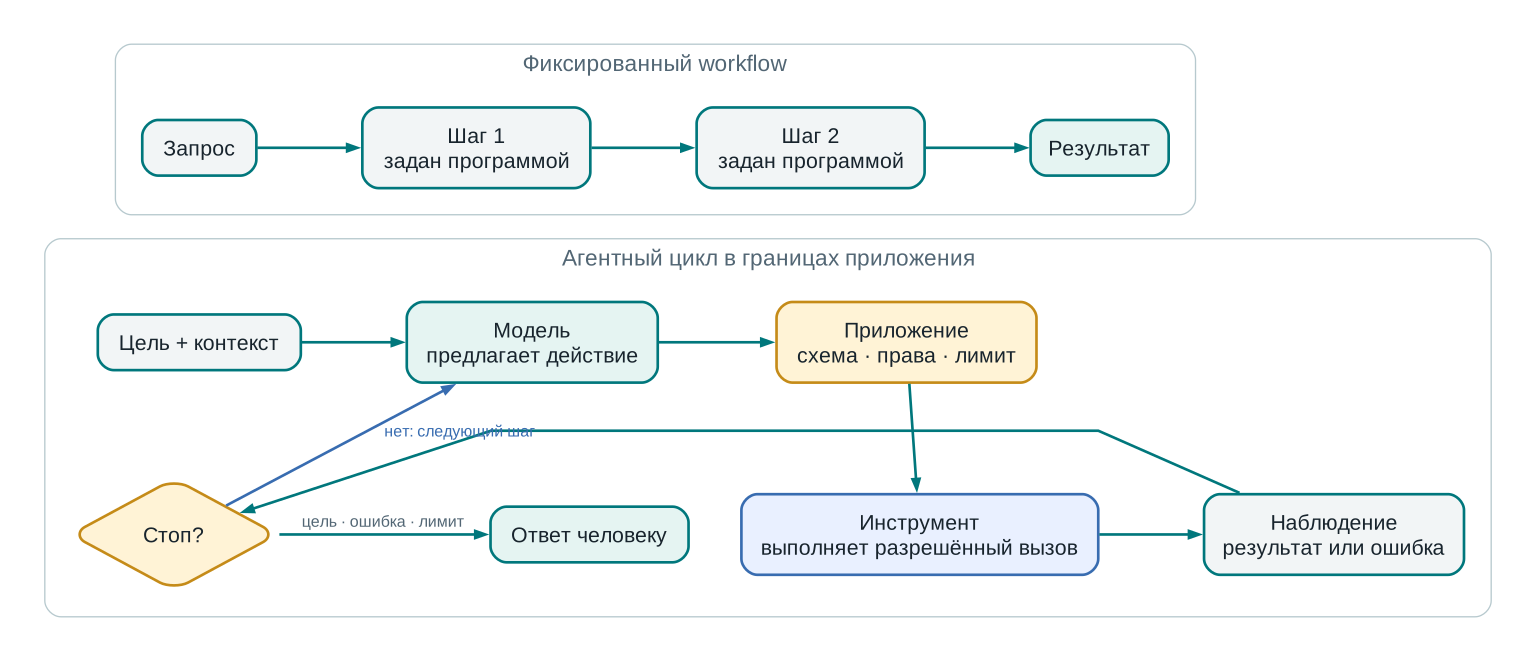
Модель может запросить вызов инструмента, но фактически исполняет функцию приложение и передаёт результат обратно модели. Такой порядок показан в документации OpenAI о работе с инструментами для функций, исполняемых приложением. Встроенные инструменты платформ могут выполняться иначе.
Следующее решение агент может принимать с учётом результата предыдущего вызова инструмента. В этом и заключается обратная связь: ответ функции влияет на дальнейшие шаги. Anthropic описывает такой цикл как характерную черту агентного подхода.
Обратите внимание на три отдельных события: модель предложила вызов, программа выполнила его, а инструмент вернул наблюдение. Если функция недоступна или аргументы отклонены, результатом шага будет ошибка, а не придуманное значение. Если сервис вернул 503, это ещё не сообщает нам причину сбоя.
Что удалось выяснить в примере с HTTP 503
Чтобы не путать механику агента с поведением реальной инфраструктуры, возьмём заранее заданные данные: get_status("api") возвращает строку HTTP 503, а get_runbook("api") — «проверить журнал и upstream». Здесь upstream — сервер или сервис, к которому обращается API.
По этим данным программа может уверенно сообщить только две вещи: функция статуса вернула 503, а инструкция предложила дальнейшую проверку. Рекомендация полезна, но она не устанавливает причину. Ошибка могла возникнуть на разных участках обработки запроса; без дополнительных наблюдений выбрать один из них нельзя.
В нашем упрощённом сценарии при статусе HTTP 200 инструкция вообще не запрашивается. Это означает лишь, что данный маршрут диагностики закончился после первой проверки. Сам по себе один ответ 200 не доказывает исправность всей системы.
Такое разделение особенно важно для агентных систем. Если модель написала «сервис восстановлен», но приложение не выполнило повторную проверку, перед вами неподтверждённый вывод. В хорошем отчёте должны различаться данные, полученные от инструментов, интерпретация модели и её рекомендации.
Как выглядит цикл на Python
Теперь заглянем внутрь программы. Чтобы увидеть основной механизм, нам не нужен большой фреймворк. Достаточно функций для чтения данных, структуры запроса инструмента и цикла, который передаёт результат в следующий шаг.
Есть важная деталь: в этом учебном примере нет настоящей LLM. Её место занимает функция choose_next с заранее заданными правилами. Это позволяет воспроизводимо проверить исполнение инструментов, ошибки и остановку. Качество самостоятельного планирования языковой модели такой тест не оценивает.
Посмотрите на часть choose_next из полного примера:
def choose_next(observations: list[Observation]) -> Call | Finish:
    """Детерминированная заглушка решения, НЕ языковая модель."""
    if not observations:
        return Call("get_status", "api")
    last = observations[-1]
    if last.tool == "get_status" and last.result == "HTTP 503":
        return Call("get_runbook", "api")
    if last.tool == "get_status":
        return Finish("Сервис отвечает; дополнительных проверок нет.")
    return Finish("HTTP 503; следующий шаг: " + last.result + ".")
Это фрагмент, его не нужно запускать отдельно: типы Call, Finish и Observation определены в полном примере XNova. Там же находятся исполняемый agent_loop.py и девять pytest-тестов.
Что происходит в коде? При первом обращении наблюдений нет, поэтому функция предлагает проверить статус. Если получен HTTP 503, следующим действием становится чтение инструкции. Иначе функция предлагает закончить. Это обычные условия Python; при подключении LLM решение о следующем инструменте вырабатывала бы модель.
Вторая половина примера — run_loop. Она принимает решение, сверяет имя инструмента со списком available, проверяет значение service, вызывает функцию и сохраняет ответ. Для неизвестного инструмента возвращается blocked, для ошибки выполнения — error; max_steps ограничивает число вызовов. Эти условия проверяет код приложения, а не текст инструкции модели.
Чтобы повторить весь проверенный пример, откройте закреплённый commit по ссылке выше, получите файлы репозитория и запустите из его корня:
python -I agent_loop.pyВывод для локальных учебных данных:
get_status(api) -> HTTP 503
get_runbook(api) -> проверить журнал и upstream
completed: HTTP 503; следующий шаг: проверить журнал и upstream.
На примере виден порядок вызовов локальных функций и условие завершения цикла. Настоящего HTTP-запроса, работы LLM или поиска причины сбоя в этом опыте нет.
Можно попробовать изменить max_steps на 1: цикл остановится после первой функции со статусом limit. Если вместо чтения статуса запросить неразрешённый delete_logs, исполнитель отклонит действие. Девять pytest-тестов проверяют эти и другие ветви, включая ошибку инструмента и неверные аргументы.
При подключении настоящей модели нужен адаптер, преобразующий её ответ в Call или Finish. Потребуются также ограничения времени, обработка неожиданных ответов и отдельные тестовые задачи для оценки решений модели. Исправный цикл ещё не гарантирует хорошую диагностику.
Что ограничивает действия агента
Представьте, что модель правильно выбрала чтение журнала, но затем решила удалить старые записи «для очистки». Если приложение предоставляет ей обе операции без проверки прав, ошибка в решении модели превращается в изменение реальных данных.
Предложение модели вызвать инструмент не заменяет проверку аргументов и полномочий в исполняющем приложении. OWASP относит избыточные функции, права и самостоятельность к риску Excessive Agency — чрезмерной автономности системы.
В нашем примере разрешены только get_status и get_runbook. Код отдельно проверяет service, поэтому путь вроде ../../secrets не пройдёт как название сервиса. Но это учебная проверка двух значений, а не полноценная авторизация. В рабочем приложении потребуется проверять личность и полномочия пользователя, доступ к конкретному ресурсу и границы выполнения каждого инструмента.
У цикла должны быть условия остановки: достижение цели, ошибка или установленный предел шагов. Об этом напоминают и OpenAI, и Anthropic. Число вызовов и время работы стоит ограничивать на уровне исполнителя: иначе неудачный шаг может снова и снова порождать запросы.
Для действий, меняющих состояние, одного разрешённого имени функции недостаточно. Например, перед перезапуском сервиса можно запросить согласование, проверить точные аргументы и права, а после действия — снова измерить состояние системы. Если агент сообщает «исправлено», подтверждением должен быть результат проверки, а не уверенный тон сообщения.
В настоящих системах к этому добавляются тайм-ауты, обработка недоверенных ответов инструментов и контроль повторных действий. Для вводного примера достаточно увидеть основной принцип: модель выбирает действие, но его границы устанавливает программа.
Когда AI-агент действительно нужен
Попробуйте начать с простого вопроса: можно ли заранее описать все необходимые шаги? Если да, обычный программный сценарий часто оказывается надёжнее: его поведение легче повторить, покрыть тестами и объяснить при сбое.
Агентный подход полезнее там, где каждый результат меняет направление дальнейшей работы. При диагностике API один ответ может потребовать чтения журнала, другой — проверки зависимостей, третий — уточнения исходных условий. Модель помогает выбирать следующие действия из доступных вариантов. Однако за эту гибкость приходится отдельно проверять правильность выбора и ограничивать последствия ошибок.
Для первого прототипа обычно достаточно одной модели и нескольких хорошо описанных инструментов. Многоагентная архитектура оправдана, когда её преимущества подтверждены задачами и измерениями, а не просто количеством взаимодействующих моделей.
Перед разработкой ответьте себе на три вопроса: какой выбор вы передаёте модели, какие действия ей доступны и что будет считаться подтверждением результата? Если выбора почти нет, разумнее написать обычный код. Если он есть и последствия действий можно контролировать, у агентного подхода появляется конкретная задача.
Теперь вы знаете, что отличает LLM-агента от окна чата: система может выбирать действия по ходу работы и опираться на новые наблюдения. Учебный пример показал, где заканчивается решение и начинается исполнение. Для рабочего агента следующим шагом станут подключение модели, проверки её решений и испытания на ситуациях, которых не было в заранее заданном сценарии.
Источники
- Определение агента, модель/инструменты/инструкции, цикл, условия остановки и контроль
- Первичное объяснение function calling: модель запрашивает инструмент, приложение выполняет функцию
- Различие агента и заданного workflow, цикл обратной связи и выбор простейшей достаточной архитектуры
- Риск чрезмерных полномочий и автономности при вызовах инструментов
- Официальное руководство по pytest для автономных тестов Python-примера
- Закреплённый commit воспроизводимого примера и pytest-тестов