
В отчёте о выручке должны оказаться только оплаченные заказы. Приложение отдаёт записи с разными статусами, а суммы приходят строками. Чтобы получить пригодную для отчёта таблицу, данные нужно извлечь, проверить, преобразовать и сохранить. В какой момент преобразовать их — до загрузки в аналитическое хранилище или после?
Это ключевое отличие двух распространённых подходов. ETL означает Extract, Transform, Load — извлечение, преобразование, загрузка. ELT — Extract, Load, Transform: исходные записи сначала попадают в целевую систему, а преобразования идут следом. Оба подхода могут использовать SQL, планировщик задач и одни и те же источники.
Разберём определения, сравним маршруты на одинаковых заказах и посмотрим, как выбирать между ними. Для чтения достаточно понимать таблицы и базовый SELECT. На одних и тех же заказах покажем, какое место занимает преобразование в каждом маршруте.
Что такое ETL
В ETL данные сначала извлекают, затем преобразуют и только после этого загружают в целевое хранилище.
- Extract (извлечение) — получить данные из базы приложения, API или файла. Источник может отдавать целую таблицу, её изменения или новые сообщения.
- Transform (преобразование) — привести типы, удалить или отметить ошибочные записи, выбрать нужные статусы, сопоставить данные из разных источников и рассчитать поля для потребителей.
- Load (загрузка) — записать подготовленные результаты в целевую таблицу, хранилище или озеро данных.
В задаче с заказами отдельная программа получает три записи, проверяет суммы и записывает только оплаченные заказы в paid_orders. В самой таблице отчёта остаётся ровно тот набор полей, который нужен потребителю. Преобразование может выполнять программа, SQL в промежуточной базе или специальный инструмент обработки: термин ETL задаёт порядок относительно целевого хранилища, но не обязывает использовать конкретный продукт.
ETL полезен, когда перед записью в целевую систему необходимо убрать поля с ограниченным доступом, выполнить сложные преобразования во внешнем вычислительном окружении или соблюсти требования к уже существующей схеме. Он не гарантирует, что у вас нигде не сохранится исходная копия: она может оставаться в источнике или отдельном промежуточном хранилище. Определение ETL и последовательность этапов также приводятся в документации Google Cloud.
Что такое ELT
В ELT данные сначала загружают в целевую систему, а преобразования выполняют уже после загрузки.
При таком подходе процесс извлечения переносит записи, например, в raw_orders. Их исходные значения сохраняются в таблице, а отдельный SQL-запрос создаёт подготовленную витрину paid_orders. Если завтра потребуется считать другую метрику, новую витрину можно построить из сохранённого исходного слоя без повторного обращения к приложению — если в нём сохранились все необходимые записи.
Условие важно: если исходный слой неполон, повреждён или очищен по сроку хранения, ELT не позволяет восстановить отсутствующие события. Кроме того, загрузка необработанных записей не отменяет контроля данных. При ELT исходные записи могут храниться рядом с подготовленными таблицами, поэтому права доступа и срок хранения нужно продумывать отдельно. Не разрешённые для хранения в аналитической системе поля следует удалить или защитить ещё до её границы.
ELT удобно рассматривать, когда хранилище умеет выполнять необходимые преобразования, команда уверенно работает с SQL, а исходные данные допустимо сохранять для повторных расчётов. Пример такой архитектуры и разделения загрузки и преобразования описан в документации BigQuery. Это пример возможностей конкретной платформы, а не обязательное устройство всех ELT-конвейеров.
ETL и ELT: в чём разница
Разница определяется тем, когда и где выполняется преобразование относительно загрузки в целевую систему. Оба подхода решают задачу получения подготовленных данных; при этом требования к доступу, обработке ошибок и целостности остаются.
| Критерий | ETL | ELT |
|---|---|---|
| Порядок этапов | Извлечь → преобразовать → загрузить | Извлечь → загрузить → преобразовать |
| Где выполняется основное преобразование | До целевого хранилища, например в отдельном процессе | В целевой системе, например SQL-запросами к исходному слою |
| Что первоначально получает целевая система | Подготовленные записи | Исходные записи или близкое к ним представление |
| Повторный расчёт | Требует доступа к источнику либо сохранённого промежуточного набора | Может использовать сохранённый исходный слой |
| Вычислительные ресурсы | Нужны ресурсы для преобразования до загрузки | Нужны ресурсы целевой системы для преобразования |
| Контроль доступа | Проверяется в источнике, обработке и целевой системе | Дополнительно существенен доступ к загруженному исходному слою |
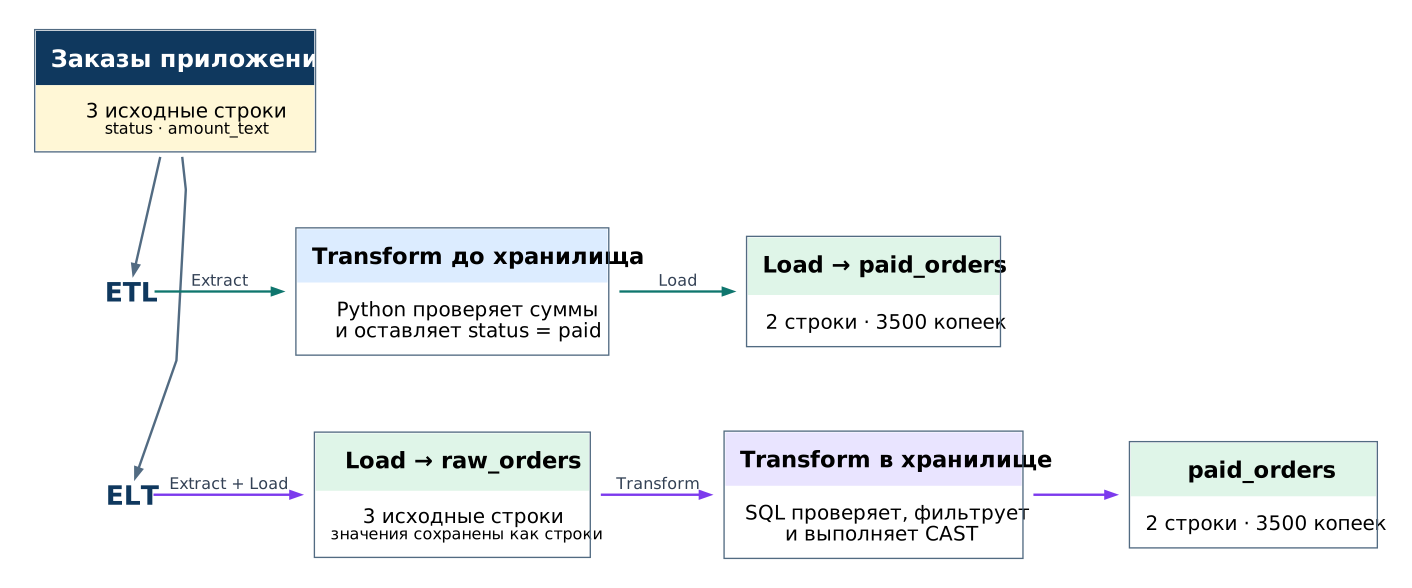
На схеме один и тот же набор из трёх заказов проходит двумя маршрутами. В ETL Python проверяет и фильтрует записи до загрузки в paid_orders. В ELT сначала появляется исходный слой raw_orders, а затем SQL внутри целевой системы создаёт ту же подготовленную таблицу.
На практике решающими оказываются ограничения на исходные данные, доступное место для преобразований и необходимость повторных расчётов. Разобрать эти критерии удобнее после примера.
Что такое data pipeline
Data pipeline, или конвейер данных, — последовательность действий, которая доставляет данные от источника до потребителя. ETL и ELT — два возможных порядка операций внутри такого конвейера, а не названия конкретных программ.
Помимо извлечения, загрузки и преобразования, реальному конвейеру нужны расписание или событие запуска, обработка ошибок, наблюдаемость и правила повторов. Например, ежедневная выгрузка заказов должна ответить на вопросы: как заметить пропущенный запуск, что делать с повторно полученным заказом и как исправить неверную запись, уже попавшую в отчёт?
ETL и ELT описывают порядок этапов; требования к повторам, проверкам и наблюдаемости задаются отдельно. У Snowflake, например, Streams и Tasks позволяют обнаруживать изменения, запускать SQL по расписанию или условию и связывать задачи в последовательности. Но наличие таких механизмов само по себе не определяет, выполняется в конкретной цепочке ETL или ELT.
Конвейер может работать пакетами или непрерывно. В обоих режимах качество данных и устойчивость к сбоям нужно проверять предметно, а не выводить из аббревиатуры.
Пример ETL и ELT на одних заказах
Возьмём три записи, которые приложение отдаёт в виде кортежей order_id, status, amount_text. Суммы указаны в копейках строкой, без дробных чисел. В отчёт должны попасть только оплаченные заказы:
| Заказ | Статус | Сумма из источника |
|---|---|---|
o-101 | paid | "1200" |
o-102 | paid | "2300" |
o-103 | cancelled | "900" |
В примере обе схемы используют Python и SQLite в памяти, но порядок операций разный. Для ETL проверка статуса и суммы делается в Python до записи в paid_orders. Сначала получается список подготовленных записей, и только затем он загружается в таблицу. Для ELT все три исходные записи сначала попадают в raw_orders как строки. Затем SQLite проверяет их и создаёт paid_orders запросом:
INSERT INTO paid_orders (order_id, amount_cents)
SELECT order_id, CAST(amount_text AS INTEGER)
FROM raw_orders WHERE status = 'paid';
Перед этим запросом в исполняемом примере есть проверка: сумма должна состоять из 1–9 ASCII-цифр, а статус — быть paid или cancelled. Это важно: согласно правилам преобразования типов SQLite, строка 12oops при CAST в целое число превратится в 12 без ошибки. Поэтому просто применить CAST и считать результат очищенным нельзя. В ETL аналогичное правило проверяет функция Python до загрузки. База paid_orders защищена первичным ключом order_id и ограничением неотрицательной суммы.
В обоих маршрутах подготовленная таблица содержит два оплаченных заказа на общую сумму 3500 копеек. Это строки ('o-101', 1200) и ('o-102', 2300). В ELT исходная таблица raw_orders при этом сохраняет все три записи, включая отменённую: в ETL такая таблица в целевой системе не создаётся.
Повторная обработка того же полного снимка не меняет итоговую таблицу. Если подставить 12oops вместо суммы заказа, обе реализации отклонят данные и сохранят предыдущий корректный результат; в ELT исходный слой также останется без изменений благодаря откату транзакции. Для потока независимых событий с возможными повторными доставками потребовалась бы другая стратегия обновления — этот пример работает именно с полными снимками.
Исходный код, проверки и инструкции по запуску доступны в открытом репозитории XNova.
Что выбрать: ETL или ELT
Начните с ограничений, которые нельзя обойти сменой технологии:
- Разрешено ли хранить исходные данные? Если в аналитическую систему нельзя помещать персональные или секретные поля, до границы загрузки нужна их очистка или надёжная защита. Сам по себе ELT не освобождает от этого требования.
- Где доступно подходящее вычислительное окружение? Если основные преобразования уже выполняются отдельным сервисом или требуют специальных библиотек, ETL может проще встроиться в существующую архитектуру. Если данные хранятся в системе с удобными SQL-преобразованиями, ELT позволяет использовать её вычислительные возможности.
- Нужны ли повторные расчёты по исходным записям? Для ELT можно сохранять исходный слой и независимо пересчитывать несколько витрин; у ETL аналогичную задачу решают через сохранённую исходную или промежуточную копию.
- Как считать стоимость? Учитывайте хранение исходного слоя, объём данных, отдельные вычислительные ресурсы, повторные преобразования и расписание. Не переносите обещания конкретного облачного сервиса на другую систему без измерений.
- Как обрабатывать ошибки и повторы? Заранее задайте ключ записи, политику обновления и действия при частичной загрузке. Для обоих подходов важна согласованность исходного набора и отчёта.
Пример решения: если данные приходят из нескольких API и до хранения требуется удалить запрещённые поля, выделите проверку и очистку до загрузки. После этого допустимые записи можно сохранить в исходном слое и строить из них витрины SQL-запросами. Такое сочетание не нужно искусственно относить только к ETL или ELT: важно, что выполняется до границы хранения, а что после.
При одних и тех же требованиях возможны обе реализации. Выбор фиксируйте через ограничения и проверяемые критерии, а не тезис «ELT современнее ETL».
Границы применения
Сам по себе порядок ETL или ELT не гарантирует меньшую стоимость, более быструю обработку или лучшее качество данных. Для количественного сравнения понадобились бы одинаковый объём записей, ресурсы, условия загрузки, число повторных расчётов и метод измерения. Здесь такого эксперимента не проводилось.
SQLite в учебном примере показывает порядок операций, но не позволяет сравнить производительность ETL и ELT в облачном хранилище. Это база в памяти, а не распределённый аналитический движок. Проверка трёх заказов не покрывает изменения схемы, параллельные записи, очень большие суммы, сетевые сбои и неполные пакеты.
Есть ещё два ограничения интерпретации:
- Повторная загрузка. В примере перед вставкой удаляются строки предыдущего снимка внутри транзакции. Поэтому повтор полного одинакового снимка не меняет результат. Это не подход для произвольных потоков событий, где могут требоваться версия события, дедупликация и инкрементальное обновление.
- Некорректные записи. Проверка отбрасывает весь снимок с нечисловой суммой. В производственной системе можно изолировать ошибочную запись в отдельной таблице, но тогда нужно определить правила уведомления и повторной обработки. Молчаливое преобразование
12oopsв число12нельзя считать успешной очисткой.
Итог
ETL преобразует данные до загрузки в целевое хранилище. ELT сначала загружает их и выполняет преобразования внутри целевой системы. Data pipeline объединяет доставку, преобразования, проверки и эксплуатацию независимо от выбранного порядка.
Если исходные записи нельзя хранить в целевой системе, их нужно преобразовать или защитить до загрузки. Если хранение допустимо и нужны повторные расчёты, стоит рассмотреть ELT. Окончательный выбор зависит от ресурсов, стоимости и того, как конвейер обрабатывает ошибки и повторные загрузки.
Источники
- Определения ETL и ELT и место преобразований при загрузке в хранилище
- Определение ETL, этапы загрузки и ограничения сравнений
- Определение ELT, исходные данные, выбор схемы и контроль доступа
- Первичная документация BigQuery о выборе последовательности загрузки и преобразований
- Компоненты непрерывного конвейера и независимые задачи загрузки и преобразования
- Python sqlite3 как локальный runtime для будущего учебного примера
- Правила таблиц и ограничений SQLite
- Правила CAST в SQLite: преобразование числового префикса строки в целое число
- Типизированный ETL/ELT-пример, pytest-сценарии и команды запуска в закреплённом публичном commit