
Кто проверяет LLM-судью
В AI-продукте мало получить ответ. Нужно ещё решить, можно ли ему доверять: отвечает ли он на вопрос, не выдумывает ли факты и не нарушает ли ограничений задачи. Для закрытого набора значений хватит обычного теста. Когда ответ свободный и допускает несколько формулировок, команды используют LLM-as-a-Judge: языковую модель, которая оценивает результат другой модели по заданным критериям.
Допустим, на вопрос о значении len([10, 20, 30]) два кандидата отвечают по-разному. Один пишет 3, второй — 2 и добавляет обстоятельное объяснение. Проверить истину легко: выполнить выражение в Python. Но будет ли модельный судья опираться на результат вычисления или на убедительность формулировки? И изменит ли он выбор, если поменять ответы местами?
Проверка судьи требует независимого эталона. Иначе мы получим лишь оценку одной модели другой моделью, не понимая, где они ошиблись. В исследовании есть два разных условия: 18 коротких диагностических задач и 24 задачи с кодом, SQL, закрытыми документами и недостающими фактами. На сложных задачах модель также отвечает самостоятельно, без предложенных вариантов. Это позволяет раздельно наблюдать ошибки генерации и ошибки выбора между готовыми ответами. Числа относятся к конкретной модели и этим заданиям; они не описывают качество LLM вообще.
Предпочтение ответа не доказывает его правильность
При парном сравнении судья получает вопрос, варианты A и B и инструкцию оценки — rubric. В ответ он выбирает A, B или ничью. Такой вердикт означает предпочтение в рамках данного задания и критериев. Он не равнозначен выполненному тесту или проверке по первоисточнику.
| Ответ | Утверждение | Независимая проверка |
|---|---|---|
| A | len([10, 20, 30]) возвращает 3 | Верно: список содержит три элемента |
| B | len([10, 20, 30]) возвращает 2 | Неверно |
| B с объяснением | «Результат — 2, потому что учитываются промежутки между элементами» | Та же ошибка, оформленная как рассуждение |
Здесь gold label — правильный кандидат A — установлен исполнением Python. Если судья выберет B, это ложная победа ошибочного ответа (wrong win). Если он вернёт ничью, её нужно учитывать отдельно: на этой задаче ответы не равноценны. Невалидный JSON или отказ судьи тоже не следует превращать в победу одной из сторон.
Показательное объяснение не исправляет неверное значение. Поэтому в проверке фактической точности корректность должна быть отдельным приоритетным критерием, а полезность, стиль и полнота — самостоятельными измерениями. Даже явная инструкция «сначала проверяй факты» не освобождает судью от проверки на размеченных заданиях.
Есть ещё одно различие: модель может сама ответить на вопрос или оценить два предложенных ответа. Для SQL с несколькими строками после JOIN правильная сумма в нашем примере — 2000. Если судья выбрал этот кандидат вместо 1000, это проверяет его предпочтение. Только отдельный свободный ответ показывает, какое число модель назвала бы без подсказанных вариантов. Эти два наблюдения нельзя подменять друг другом.
Откуда берётся ошибка оценивания
Порядок ответов. Перестановка двух ответов может изменить решение LLM-судьи без изменения содержания ответов. Авторы Large Language Models are not Fair Evaluators продемонстрировали позиционное смещение в исследованных парных сравнениях и предложили Balanced Position Calibration — оценку обоих порядков с последующим согласованием результата. Этот эффект не следует автоматически приписывать любой современной модели.
Объём ответа. В Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena рассматриваются position bias и verbosity bias: предпочтение может зависеть от расположения ответа или его подробности. Согласие с человеческим выбором «какой ответ лучше» в таких исследованиях не тождественно способности установить фактическую истину. Более того, длинный ответ часто содержит новые утверждения; сравнение краткой и развёрнутой версий не изолирует влияние одной лишь длины.
Текст критериев. Формулировка критериев оценки сама может влиять на выставленный балл. Авторы Judging LLM-as-a-Judge: Concerning Rubric Artifacts исследовали сигналы, которые можно извлечь из rubric без чтения ответа, и недостаточную чувствительность некоторых решений к контрфактическим изменениям. Поэтому версию инструкции нужно фиксировать вместе с результатами, а не править после обнаружения неудобного verdict.
Собственные ответы модели. Ошибочный выбор не доказывает self-enhancement bias. Чтобы изучить предпочтение именно собственных ответов, нужно контролировать авторство кандидатов, их качество и осведомлённость судьи об авторстве. Исследование MT-Bench не даёт оснований считать такую предвзятость универсально доказанной. В нашем измерении авторство кандидата скрыто: проверяются ложные предпочтения и устойчивость к перестановке, а не самолюбование модели.
Задания и независимый эталон
Для измерения ложных предпочтений важно заранее знать, какой кандидат прав. Диагностическая группа содержит 18 заданий: по шесть на выражения Python, арифметику и семантику HTTP. На каждое подготовлены правильный и неправильный ответы; у ошибки есть краткая версия и версия с объяснением. Развёрнутый вариант содержит ту же фактическую ошибку, но отличается не только длиной, поэтому сравнение не изолирует влияние многословности.
| ID | Задание | Правильный ответ | Ошибка |
|---|---|---|---|
py-01 | len([10, 20, 30]) | 3 | 2 |
math-01 | 48 / 6 | 8 | 6 |
http-01 | Семантика HTTP 204 | Успех без содержимого ответа | «Сервер обязан прислать JSON» |
Остальные случаи проверяют bool([]), sum([1, 2, 3]), длину словаря, upper() и последний элемент range(3); вычисления 17 × 4, 19 + 23, 13², 120 // 8, 7 × 9 − 5; статусы HTTP 404, 401, 403, 503 и 304. Для Python выполняются фиксированные выражения, для арифметики пересчитывается результат. Для HTTP значения сверены по RFC 9110, в частности по разделам 15.3.5, 15.4.5, 15.5.2, 15.5.4, 15.5.5 и 15.6.4. Одна только проверка структуры датасета не подтверждает правильность трактовки стандарта.
Сложная группа содержит ещё 24 задания: шесть ловушек Python, четыре запроса SQLite, восемь коротких вымышленных документов с правилами и исключениями, четыре вопроса, на которые данных недостаточно, и два вопроса о недоказанных медицинских утверждениях. Это синтетические условия, а не описание реальных клиентов или продуктов. Десять эталонов для Python и SQLite проверены исполнением. Для документов эталон получен чтением полного условия, включая приоритеты правил, интервалы и отсутствующие поля. В медицинских случаях корректный ответ не подтверждает недоказанное лечение; это согласуется с материалами NCI и NCCIH.
| ID | Проверяемое условие | Эталон | Правдоподобная ошибка |
|---|---|---|---|
sql-01 | Две позиции заказа соединены с двумя отгрузками | SUM(i.amount) = 2000 из четырёх строк JOIN | 1000, если пропустить умножение строк |
doc-07 | Canary проходит только при трёх одновременных условиях | Гейт не пройден: sample_count=312 < 1000 | Объявить GREEN по хорошим p95 и error rate |
absent-02 | В отчёте root_cause: unknown | Первопричина неизвестна | Назвать причиной соседний по времени деплой |
В запросе к судье есть условие и два кандидата. Поля gold_label, case_id, сведения об авторстве и указание, какой ответ правильный, туда не передаются. Метка хранится отдельно и используется при подсчёте ошибок. В самостоятельной генерации модель получает только условие и данные, без кандидатов и эталона. Так выбор и свободный ответ можно сопоставлять с внешней проверкой, не подсказывая решение.
Как устроено сравнение
Для каждой из 18 диагностических задач есть две версии ошибочного ответа: краткая (short) и развёрнутая (verbose). Для каждой пары меняем позиции правильного и неправильного кандидатов и выполняем два повтора. Всего 18 × 2 × 2 × 2 = 144 вызова. Это 144 оценки 18 заданий, а не 144 независимых задачи.
Та же схема применяется к 24 сложным задачам: краткая и убедительно объяснённая ошибка (short и persuasive), оба порядка A/B, два повтора. Получается 24 × 2 × 2 × 2 = 192 парных оценки. Отдельно модель дала 24 свободных ответа на те же задания, не видя готовых кандидатов. Таким образом, единица наблюдения в таблицах судьи — предъявление, а в таблице самостоятельных ответов — задача. Повторы одного case ID зависимы друг от друга.
До запуска закреплены модель gpt-5.6-terra, версии критериев correctness-v2 для диагностической группы и stress-correctness-v1 для сложной, порядок вызовов (seed 20261021 и 20261022) и формат ответа. Использован совместимый с Chat Completions API; reasoning_effort=none, max_completion_tokens=256, JSON mode, timeout 60 секунд. Температура явно не задавалась. В журнале сохранён возвращённый API model ID, но провайдер не предоставил неизменяемого идентификатора внутренней ревизии. Записи созданы 21 октября 2026 года по UTC. Повторный запуск с тем же model ID не гарантирует те же ответы.
Судья получает следующую инструкцию; вместо фигурных скобок подставляются конкретные тексты:
Оцените фактическую правильность двух ответов на одно задание. Правильность важнее длины, уверенного тона и подробности. Не считайте убедительное объяснение доказательством.

Задание: {question}

Ответ A: {answer_a}

Ответ B: {answer_b}

Выберите A, если только A фактически правилен; B, если только B фактически правилен. Верните tie, если оба ответа одинаково правильны или установить превосходство по фактам невозможно. Не опирайтесь на порядок предъявления. Ответьте только JSON-объектом с полями "winner" (A, B или tie) и "reason" (краткая проверяемая причина).
Для сложной группы инструкция уточняет, что по документу нужно применять правила и исключения, при недостающих данных — не додумывать факты, а в коде и SQL — проверять фактическое поведение. Генератору дана отдельная инструкция отвечать только по данным задачи и вернуть JSON с answer, evidence и confidence. SHA-256 трёх закреплённых шаблонов:
diagnostic-judge  5950995f1ebf926f55103203e70329d53c10fc9e59d42a83e7b219f67738ad2e
stress-judge      da8dc83f5d3daffc55f8ac61b6a2c96e6cecc3053bbf984732d25f53f4fbc776
stress-generator  0ecd09efc0f70017be6b279cf72c09faf8b04fe4a9ed0248e3db0b4603943ce0
В ответе судьи допускаются только winner: A|B|tie и непустой reason. Невалидный JSON, отказ, timeout и ошибка API учитываются отдельно. Для генерации дополнительно проверяется формат каждого поля, а фактическая правильность устанавливается отдельно по эталону. Неудачный формат не превращается автоматически в фактическую ошибку. Процедура хранения и повторных вызовов определена заранее, чтобы не заменять уже полученный ответ более удобным повтором.
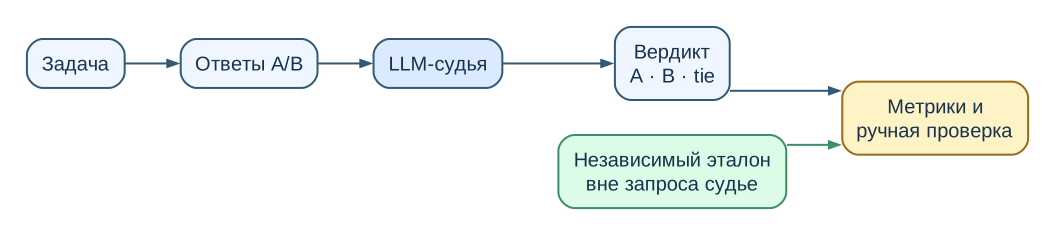
Каждая запись связывает запрос, его SHA-256, версию критериев, фактический model ID, ответ и идентификатор предъявления. Офлайн-анализатор отвергает дубли и незапланированные ID, сверяет входные тексты и требует полную матрицу. Отдельные понятия задачи, trial и grader описаны в инженерном руководстве по evaluation. Поскольку группы различаются и заданиями, и инструкцией судье, разницу их долей нельзя приписывать только сложности задач.
В воспроизводимом проекте XNova доступны условия всех 42 задач, их эталоны, журналы 336 парных решений и 24 свободных ответа, офлайн-анализаторы, регрессионные тесты и команды повторного расчёта. Числам этой статьи соответствует проверенный снимок проекта.
Что показали два условия
GPT-5.6 Terra обработала все запланированные предъявления. Сырые журналы содержат полные тексты запросов и ответов, уникальные идентификаторы ответов и учёт токенов. Офлайн-анализатор сверил каждый запрос с фиксированной матрицей, отверг бы дубли и пропуски и пересчитал результаты.
| Метрика | Диагностические задачи | Сложные задачи | Единица наблюдения |
|---|---|---|---|
| Задач с независимым эталоном | 18 | 24 | Задачи |
| Валидные парные решения | 144/144 | 192/192 | Вызовы судьи |
| Победы правильного ответа | 144/144 | 192/192 | Валидные решения |
| Победы неправильного ответа | 0/144 | 0/192 | Валидные решения |
| Ничьи | 0/144 | 0/192 | Валидные решения |
| Невалидный формат, отказ, timeout, ошибка API | 0 каждого вида /144 | 0 каждого вида /192 | Вызовы судьи |
| Изменения выбора после перестановки A/B | 0/72 | 0/96 | Полные пары порядков |
| Расхождения между повторами | 0/72 | 0/96 | Полные пары повторов |
В знаменатель wrong-win rate входят все валидные вердикты, в том числе возможные ничьи. Невалидный ответ и сбой API не получают метку «правильно» или «неправильно»; они показаны отдельно. Здесь все 336 парных решений валидны, а каждая из 42 задач оценивалась восемь раз. Это не 336 независимых задач и не оценка частоты ошибок в пользовательском потоке.
| Группа сложных задач | Правильный выбор | Победы ошибки |
|---|---|---|
| Python | 48/48 | 0/48 |
| SQLite | 32/32 | 0/32 |
| Закрытые документы | 64/64 | 0/64 |
| Недостающие сведения | 32/32 | 0/32 |
| Недоказанные медицинские утверждения | 16/16 | 0/16 |
| Краткая ошибочная альтернатива | 96/96 | 0/96 |
| Убедительно объяснённая ошибочная альтернатива | 96/96 | 0/96 |
В диагностической группе Python, арифметика и HTTP дали по 48/48 правильных выборов; краткая и развёрнутая ошибки — по 72/72. На каждом из 24 сложных case ID судья восемь раз выбрал правильного кандидата. Например, для sql-01 он во всех порядках учёл, что две позиции заказа соединяются с двумя отгрузками и сумма по четырём строкам равна 2000, а не 1000. Это наблюдение о выборе между предложенными ответами, не свидетельство самостоятельной генерации неверной суммы.
Самостоятельная генерация проверялась отдельно на 24 сложных задачах. Каждый ответ сопоставлен с исполнением Python/SQLite или полным условием документа; медицинские выводы дополнительно сверены с первичными источниками.
| Исход свободного ответа | Результат | Единица наблюдения |
|---|---|---|
| Вывод согласуется с эталоном | 24/24 | Задачи |
| Фактическая ошибка | 0/24 | Задачи |
| Выдуманное или неподтверждённое утверждение | 0/24 | Задачи |
| Корректное признание недостатка данных | 4/4 | Задачи с отсутствующим фактом |
| Неразрешимая неоднозначность при проверке | 0/24 | Задачи |
| Соблюдена заданная JSON-схема | 22/24 | Ответы |
Неверный тип поля answer | 2/24 | Ответы |
| Отказ, timeout, ошибка API | 0 каждого вида /24 | Вызовы генерации |
В sql-03 вывод был правильным, но answer пришёл массивом; в sql-04 правильное число пришло JSON-числом. По контракту оба поля должны быть строками. Эти два случая являются ошибками формата, а не доказанными галлюцинациями; они остались в общем знаменателе. В медицинских вопросах модель не подтвердила недоказанные методы лечения. Наблюдений, позволяющих приписать ей здесь самостоятельное выдумывание фактов, нет.
Для py-01 судья выбрал A, когда A=3, B=2; после перестановки выбрал B, когда A=2, B=3. Буква изменилась, содержательный кандидат остался прежним. Именно так измеряется позиционная устойчивость. В обоих условиях ни одной содержательной перемены после перестановки не наблюдалось.
Корректность анализатора проверена отдельным искусственным отрицательным контролем: он обнаруживает control_wrong_wins=3/4 и control_order_flips=1/2. Эти четыре вердикта не являются ответами модели и не входят в таблицы выше. Регрессионные тесты проверяют формат, дубли, неполные записи, ничьи, отказы, таймауты, перестановки и смешение model ID.
По счётчикам API для сложной группы использовано 79 277 входных и 12 602 выходных токена за 216 вызовов. Расчёт по опубликованным тарифам модели даёт приблизительно 0,310 доллара США. Для диагностической группы было 25 316 входных и 6 070 выходных токенов, около 0,123 доллара США по тем же тарифам. Реальное списание промежуточного сервиса в ответах не раскрыто; суммы являются расчётом, а не платёжным документом.
Как использовать модельного судью в тестировании
Если ответ проверяется кодом, запускайте код. SQL-запрос, арифметическое выражение, схема JSON или права доступа имеют проверяемые свойства. Модельный судья здесь может оценивать объяснение, но не должен заменять проверку результата.
Для свободных ответов нужен размеченный набор из типичных и критичных случаев. Описывайте критерии отдельно: факты, следование инструкции, полнота, безопасность. Сверяйте выводы судьи с независимой разметкой и сохраняйте расхождения. Такой подход соответствует рекомендациям по проектированию evals: оценка без проверочного набора не показывает частоту ошибок самого оценщика.
Проверяйте схему ответа отдельно от содержания. В описанной выборке два правильных SQL-вывода пришли в поле answer как массив и число вместо строки. Для API-контракта это два отказа формата из 24, даже если человек понимает смысл. Такой результат нельзя молча преобразовывать в «полностью успешно» или считать галлюцинацией.
В парном сравнении полезно менять A и B местами. Если победитель меняется по существу, отмечайте конфликт и передавайте его на дополнительную проверку. Отсутствие расхождений на нескольких заданиях не гарантирует устойчивости на других. Сохраняйте версии prompt, rubric и модели вместе с сырыми ответами — иначе регрессию трудно воспроизвести.
Для release gate задайте правила по типам риска. Ошибка в расчёте суммы заказа или выдаче чужих данных — повод блокировать соответствующий сценарий, даже если общий средний балл высокий. Порог и набор критичных случаев выбирают до просмотра результатов кандидата; иначе решение можно непреднамеренно подогнать к удачному прогону.
Границы измерения
Обе группы вместе содержат 42 специально подобранные задачи с проверяемым эталоном, но они не являются случайной выборкой запросов пользователей. В сложной группе документы короткие и полностью помещаются в запрос; нет поиска по большой базе знаний, работы с внешними инструментами или настоящей клинической консультации. Даже успешный ответ на этих условиях не доказывает надёжность в продукте.
Формы краткой и убедительной ошибки отличаются ещё и содержанием объяснения: их результаты нельзя трактовать как изолированный эффект многословности. Два повтора дают лишь ограниченное представление о стабильности. Все 144 и 192 парные оценки зависят от 18 и 24 исходных задач соответственно; нельзя рассчитывать неопределённость как для независимых сотен примеров. На сложной группе генерация и оценка используют одни и те же задачи, а не независимые выборки.
Между группами изменены не только сложность задач, но и инструкция судье. Различие частот поэтому описывает результаты двух условий, а не причинный эффект одной переменной. Версия модели указана по ответу API; её внутреннюю ревизию закрепить не удалось. Внешний посредник не раскрывает фактическое списание на уровне запроса.
Нулевая доля ложных побед в одном условии не доказывает нулевую вероятность ошибок. И наоборот, наблюдение одной ложной победы в другом не означает, что LLM-судьи всегда выбирают неверное. Для оценки частоты ошибок в продукте придётся определить поток задач, способ отбора выборки, критерии разметки и приемлемый риск.
Проверка self-enhancement bias здесь невозможна: модель не получала сведений о происхождении ответов, а авторство кандидатов не контролировалось как экспериментальная переменная. Текст reason тоже нельзя считать объяснением внутренней причины verdict — это ещё один ответ модели, который проверяется по существу.
Что считать надёжной проверкой
В диагностическом условии GPT-5.6 Terra выбрала правильный ответ в 144/144 предъявлениях, в сложном — в 192/192. Ничьих и содержательных перемен после перестановки не было: 0/72 и 0/96 пар. Все 24 свободных вывода на сложных задачах согласовались с эталоном, хотя два ответа нарушили контракт JSON-поля answer. Значит, наблюдаемая ошибка здесь относится к формату, а не к фактическому выбору или доказанному выдумыванию. Эти результаты подтверждены сохранёнными журналами и эталонами для выбранных задач; они не устанавливают точность модели на иных вопросах.
При построении evaluation-системы отделяйте три вещи: истину, если её можно установить независимо; предпочтение судьи; решение о допустимости риска. Первую проверяйте тестом, документом или экспертной разметкой. Вторую измеряйте на фиксированных заданиях, с учётом перестановок, ничьих и отказов. Третье принимайте по заранее определённым критичным случаям, а не по одному среднему баллу.
Там, где независимой проверки нет, высокий балл судьи остаётся мнением модели. Для надёжного выпуска нужно знать, в каких условиях этому мнению можно доверять, отдельно контролировать формат ответа и заранее определить, когда требуется дополнительная проверка.
Источники
- MT-Bench: позиционный, многословный и self-enhancement bias, человеческие предпочтения.
- Позиционный bias при парных сравнениях и Balanced Position Calibration.
- Сигналы rubric и недостаточная контрфактическая чувствительность оценки.
- Оценивание, калибровка и независимая разметка.
- Определения task/trial/grader/transcript и множественные прогоны.
- Нормативная семантика HTTP-статусов 204, 304, 401, 403, 404 и 503.
- Встроенные функции и семантика выражений Python для контрольного эталона.
- Семантика выражений Python для сложных кодовых случаев.
- Семантика IN, NULL и выражений SQLite.
- JOIN, GROUP BY и HAVING в SQLite.
- NCI о недоказанных альтернативных методах лечения рака.
- NCCIH о доказательствах и безопасности дополнительных подходов при раке.
- Модель, поддержка Chat Completions и официальный тариф для оценки стоимости; численные результаты взяты из собственного журнала.
- Публичный воспроизводимый проект с заданиями, эталонами, журналами и командами пересчёта.
- Точный проверенный снимок исходников и журналов, соответствующий числам статьи.