
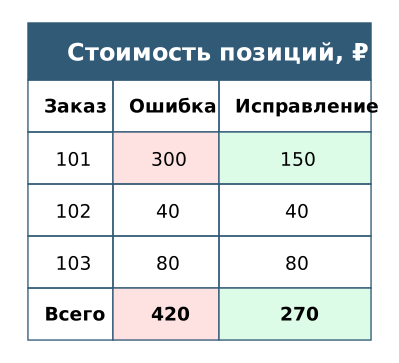
Заказ на 150 рублей в SQL-отчёте оказался заказом на 300. В исходных данных три товарные позиции с правильными ценами, запрос выполняется без ошибок, но итоговая стоимость удвоилась.
Ошибка появилась после добавления сведений об отгрузках. Отчёт должен показывать две метрики для каждого заказа: стоимость позиций и число отгрузок. У заказа может быть несколько позиций и несколько отгрузок. Если соединить обе таблицы напрямую, количество строк перед SUM изменится.
Разберём это на трёх синтетических заказах. Восстановим запрос, посмотрим промежуточные строки после JOIN, проверим причину завышения и исправим расчёт. Заодно покажем, почему SUM(DISTINCT ...) в этом случае даёт ещё более неправильный результат.
Все примеры запускаются в SQLite без сервера БД. Суммы хранятся целыми копейками, чтобы не смешивать ошибку соединения с округлением. Мы считаем стоимость товарных позиций, а не фактически полученную выручку: платежи, скидки и возвраты в данных отсутствуют.
Три таблицы с разной детализацией
Отчёт строится по трём таблицам:
| Таблица | Что означает одна строка | Ключ |
|---|---|---|
orders | Один заказ | order_id |
order_items | Одна товарная позиция заказа | item_id |
shipments | Одна отгрузка заказа | shipment_id |
Связи orders → order_items и orders → shipments обе имеют кратность «один ко многим». Сам order_id не уникален ни в позициях, ни в отгрузках. В отчёте нужна одна строка на заказ. Это его зерно (grain) — уровень детализации, на котором определяются строки результата и ключ order_id.
Создадим данные в SQLite:
CREATE TABLE orders (
    order_id INTEGER PRIMARY KEY,
    customer_id INTEGER NOT NULL
);
CREATE TABLE order_items (
    item_id INTEGER PRIMARY KEY,
    order_id INTEGER NOT NULL REFERENCES orders(order_id),
    quantity INTEGER NOT NULL,
    unit_price_cents INTEGER NOT NULL
);
CREATE TABLE shipments (
    shipment_id INTEGER PRIMARY KEY,
    order_id INTEGER NOT NULL REFERENCES orders(order_id)
);

INSERT INTO orders VALUES (101, 1), (102, 2), (103, 3);

INSERT INTO order_items VALUES
    (1, 101, 2, 2500),  -- 2 × 25 ₽ = 50 ₽
    (2, 101, 1, 5000),  -- 1 × 50 ₽ = 50 ₽
    (3, 101, 1, 5000),  -- 1 × 50 ₽ = 50 ₽
    (4, 102, 1, 4000),  -- 40 ₽
    (5, 103, 1, 8000);  -- 80 ₽

INSERT INTO shipments VALUES
    (901, 101),
    (902, 101),
    (903, 102);
В полном SQL-файле дополнительно включены внешние ключи и ограничения на количество и цену. Здесь оставлены только поля, нужные для диагностики.
У заказа 101 три позиции на 150 ₽ и две отгрузки. У 102 одна позиция на 40 ₽ и одна отгрузка. У 103 одна позиция на 80 ₽, но отгрузок пока нет.
Проверим исходную стоимость напрямую по order_items, пока в запросе не участвуют отгрузки:
SELECT order_id,
       SUM(quantity * unit_price_cents) AS total_cents
FROM order_items
GROUP BY order_id
ORDER BY order_id;| order_id | total_cents | В рублях |
|---|---|---|
| 101 | 15000 | 150 |
| 102 | 4000 | 40 |
| 103 | 8000 | 80 |
| Итого | 27000 | 270 |
Это контрольный расчёт без соединения с отгрузками. Он позволяет заметить, что ошибка появилась при расширении запроса, но сам по себе ещё не доказывает правильность бизнес-правил расчёта стоимости.
Запрос, который удвоил сумму заказа
В исходный отчёт добавили shipments и подсчёт отгрузок. Сумму товарных позиций при этом оставили в той же группировке по order_id:
SELECT o.order_id,
       SUM(i.quantity * i.unit_price_cents) AS total_cents,
       COUNT(DISTINCT s.shipment_id) AS shipment_count
FROM orders AS o
JOIN order_items AS i ON i.order_id = o.order_id
LEFT JOIN shipments AS s ON s.order_id = o.order_id
GROUP BY o.order_id
ORDER BY o.order_id;
LEFT JOIN сохраняет заказы, для которых пока нет отгрузок, если у них есть хотя бы одна товарная позиция. Это ограничение обусловлено JOIN order_items: заказ без позиций такой запрос пропустит.
Запрос выполняется и даже правильно считает отгрузки благодаря COUNT(DISTINCT s.shipment_id). Но стоимость позиций завышена:
| order_id | Ожидаемая сумма, коп. | Сумма после JOIN, коп. | Отгрузок |
|---|---|---|---|
| 101 | 15000 | 30000 | 2 |
| 102 | 4000 | 4000 | 1 |
| 103 | 8000 | 8000 | 0 |
| Итого | 27000 | 42000 | — |
COUNT(DISTINCT ...) устраняет повторения идентификаторов отгрузок в своей метрике. SUM по-прежнему складывает все строки, порождённые JOIN. Правильность одной колонки не гарантирует правильности соседней.
Логически сначала вычисляется набор строк FROM/JOIN, затем выполняется GROUP BY и агрегирование. Так устроены табличные выражения PostgreSQL и обработка SELECT в SQLite. Физический план оптимизатора может отличаться от этой последовательности, но результат обязан сохранять её SQL-семантику.
Остаётся понять, какие именно строки попали в SUM. Для этого посмотрим результат соединения до группировки.
Диагностика: что попало в SUM до группировки
Первое диагностическое действие — посмотреть результат JOIN без агрегирования. Для этого выведем ключи позиции и отгрузки, а рядом — стоимость позиции:
SELECT o.order_id,
       i.item_id,
       s.shipment_id,
       i.quantity * i.unit_price_cents AS line_cents
FROM orders AS o
JOIN order_items AS i ON i.order_id = o.order_id
LEFT JOIN shipments AS s ON s.order_id = o.order_id
WHERE o.order_id = 101
ORDER BY i.item_id, s.shipment_id;
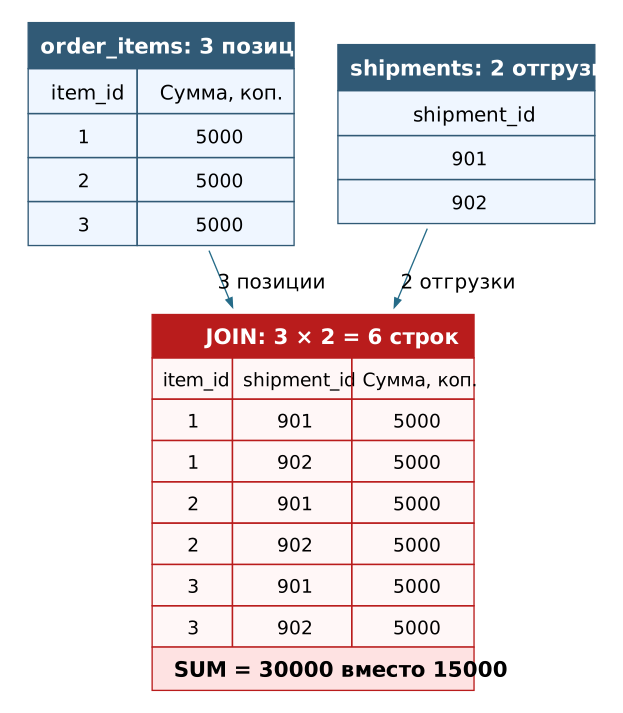
Результат для заказа 101:
| item_id | shipment_id | line_cents |
|---|---|---|
| 1 | 901 | 5000 |
| 1 | 902 | 5000 |
| 2 | 901 | 5000 |
| 2 | 902 | 5000 |
| 3 | 901 | 5000 |
| 3 | 902 | 5000 |
Каждая позиция встретилась с каждой отгрузкой того же заказа. В результате 3 позиции × 2 отгрузки = 6 строк. Для SUM это шесть слагаемых по 5000 копеек, то есть 30000, хотя исходных позиций всего три. Такое размножение строк при соединении называют fanout. SQL не создаёт новые товарные позиции в базе: он возвращает несколько сочетаний существующих строк.
Диагностику можно автоматизировать:
SELECT o.order_id,
       COUNT(*) AS joined_rows,
       COUNT(DISTINCT i.item_id) AS item_count,
       COUNT(DISTINCT s.shipment_id) AS shipment_count
FROM orders AS o
JOIN order_items AS i ON i.order_id = o.order_id
LEFT JOIN shipments AS s ON s.order_id = o.order_id
GROUP BY o.order_id
ORDER BY o.order_id;| order_id | joined_rows | item_count | shipment_count |
|---|---|---|---|
| 101 | 6 | 3 | 2 |
| 102 | 1 | 1 | 1 |
| 103 | 1 | 1 | 0 |
COUNT(DISTINCT item_id) здесь нужен для диагностики количества уникальных позиций — он не вычисляет стоимость. Для заказа 103 LEFT JOIN создаёт строку с shipment_id = NULL; поэтому COUNT(*) = 1, а COUNT(s.shipment_id) = 0.
В этой схеме каждая из m позиций заказа совпадает с каждой из n его отгрузок. При m > 0 итоговая кратность равна m × n, если отгрузки есть, и m, если их нет: LEFT JOIN сохраняет строки позиций с NULL справа. Если позиций нет, первый внутренний JOIN исключает заказ целиком. Правило относится к указанным условиям соединения; наличие уникального ключа в присоединяемой таблице изменило бы кратность.
Мы нашли место, где три исходные позиции превратились в шесть входных строк для SUM. Попытка удалить дубликаты уже внутри функции выглядит простой, но у неё другая семантика.
Почему SUM(DISTINCT …) — плохое исправление
После появления шести строк хочется убрать повторы прямо в агрегате:
SELECT i.order_id,
       SUM(DISTINCT i.quantity * i.unit_price_cents) AS total_cents
FROM order_items AS i
LEFT JOIN shipments AS s ON s.order_id = i.order_id
WHERE i.order_id = 101
GROUP BY i.order_id;
Результат — 5000 копеек вместо 15000. По правилам агрегатных функций SQLite, DISTINCT отбрасывает повторяющиеся значения аргумента, а не строки с одинаковым item_id. Наши три разные позиции стоят по 5000 копеек каждая. Для SUM(DISTINCT ...) эти три равные стоимости неразличимы, и сумма превращается в 5000.
При другом наборе цен такой приём иногда случайно возвращает правильную сумму. Например, если каждый товар имеет уникальную стоимость, он может убрать дубликаты, порождённые отгрузками. Это не делает запрос корректным: очередной заказ с двумя позициями одинаковой цены снова занизит результат.
Здесь важно, какое поле подаётся в DISTINCT: COUNT(DISTINCT i.item_id) считает уникальные позиции, а SUM(DISTINCT i.quantity * i.unit_price_cents) складывает только разные численные суммы. Удалять повторения на основании цены, если бизнес-объект определяется item_id, нельзя.
SELECT DISTINCT после агрегирования также не исправит уже завышенную сумму. Нужно изменить состав строк до SUM либо отдельно вычислять метрику на правильном уровне детализации.
Исправление: агрегируем каждую связь до одного order_id
Итоговый отчёт имеет зерно order_id: одна строка на заказ. Поэтому для каждой из двух дочерних таблиц сначала рассчитаем агрегат на этом же уровне детализации, а затем присоединим его к orders.
WITH item_totals AS (
    SELECT order_id,
           SUM(quantity * unit_price_cents) AS total_cents
    FROM order_items
    GROUP BY order_id
),
shipment_counts AS (
    SELECT order_id,
           COUNT(*) AS shipment_count
    FROM shipments
    GROUP BY order_id
)
SELECT o.order_id,
       COALESCE(t.total_cents, 0) AS total_cents,
       COALESCE(s.shipment_count, 0) AS shipment_count
FROM orders AS o
LEFT JOIN item_totals AS t ON t.order_id = o.order_id
LEFT JOIN shipment_counts AS s ON s.order_id = o.order_id
ORDER BY o.order_id;
После GROUP BY order_id в item_totals на заказ приходится максимум одна строка. Та же гарантия есть у shipment_counts. Следовательно, соединение этих двух наборов с уникальными заказами не увеличивает кратность строк отчёта.
| order_id | total_cents | shipment_count |
|---|---|---|
| 101 | 15000 | 2 |
| 102 | 4000 | 1 |
| 103 | 8000 | 0 |
Общая стоимость позиций снова равна 27000 копеек, как в независимом расчёте по order_items.
COALESCE нужен по конкретной причине: если у заказа нет позиций или отгрузок, после LEFT JOIN соответствующий агрегат равен NULL, а в этом отчёте для отсутствующих позиций и отгрузок предусмотрено значение 0. Это бизнес-решение о представлении отсутствия записей; нельзя механически превращать в ноль неизвестную сумму платежа или недоступную метрику.
Инвариант исправленного запроса — не более одной строки на order_id в каждом присоединяемом CTE. Если понадобится добавить платежи, возвраты или скидки, для каждого вида данных сначала установите бизнес-правила и нужную детализацию, а уже после этого соединяйте агрегаты. Иначе возникнет тот же fanout, только с большим числом таблиц.
SUM складывает значения всех входных строк своей группы — так это определено в документации PostgreSQL по агрегатным функциям. Чтобы получить правильный ответ, в первую очередь нужно передать ей правильные строки.
Если отгрузки нужны только для отбора — EXISTS
Иногда цель отчёта другая: посчитать стоимость позиций только тех заказов, у которых была хотя бы одна отгрузка. Число отгрузок при этом не требуется.
При условии «у заказа есть хотя бы одна отгрузка» достаточно проверить её существование. Присоединять сами строки shipments не требуется:
SELECT i.order_id,
       SUM(i.quantity * i.unit_price_cents) AS total_cents
FROM order_items AS i
WHERE EXISTS (
    SELECT 1
    FROM shipments AS s
    WHERE s.order_id = i.order_id
)
GROUP BY i.order_id
ORDER BY i.order_id;
Результат:
| order_id | total_cents |
|---|---|
| 101 | 15000 |
| 102 | 4000 |
Заказ 103 исключён, потому что отгрузок у него нет. Сумма позиций для отобранных заказов — 19000 копеек. Она меньше общего итога 27000 по ожидаемой причине: запрос решает другую задачу, оставляя только заказы с отгрузкой.
EXISTS возвращает истину или ложь для каждой строки order_items и не добавляет в неё строки из shipments. Даже если отгрузок две или двадцать, одна исходная товарная позиция остаётся одним входом для SUM.
Если же нужны обе метрики — стоимость заказа и число отгрузок — используйте предыдущий вариант с двумя предварительно агрегированными наборами.
Проверки, которые обнаружат повторное завышение
Исправленный запрос нужен не только для сегодняшних данных. При изменении отчёта важно сохранить несколько проверяемых условий.
Сумма отчёта совпадает с суммой исходных позиций. Для нашего набора расчёт без соединений:
SELECT SUM(quantity * unit_price_cents) AS source_total_cents
FROM order_items;
возвращает 27000 копеек. Сумма total_cents по исправленному отчёту также должна быть 27000. При тестировании реальной витрины обе стороны сверки должны использовать одинаковые границы периода и правила учёта статусов, возвратов и скидок. Здесь сверяются два способа вычисления одной демонстрационной стоимости, а не две независимые системы учёта.
На один заказ приходится одна строка отчёта. Проверяйте уникальность order_id и сравнивайте число строк отчёта с числом заказов, которые по бизнес-условиям должны в него входить. Проверка одной лишь итоговой суммы не обнаружит пропущенный заказ, если ошибка в другой части данных её компенсирует.
Две отгрузки не меняют стоимость позиций. У 101 должно оставаться 15000 копеек и две отгрузки. Если добавить вторую отгрузку к 102, ошибочный запрос вернёт 8000 вместо 4000; исправленный оставит 4000 и покажет две отгрузки.
Новая позиция меняет стоимость один раз. Если добавить к заказу 101 позицию на 2000 копеек, исправленный отчёт покажет 17000 копеек в одной строке заказа. Ошибочный запрос с двумя отгрузками покажет 34000.
Отсутствие дочерних записей обрабатывается по контракту. Заказ 103 имеет стоимость 8000 и ноль отгрузок. Дополнительный заказ без позиций в исправленном отчёте получает стоимость 0 по принятому для этой демонстрации правилу. Ошибочный JOIN order_items такой заказ потеряет.
Совпадающая стоимость разных позиций не исчезает. Три позиции заказа 101 дают по 5000 копеек каждая. Тест против SUM(DISTINCT ...) обнаружит ошибочный итог 5000 вместо 15000.
В примере эти условия проверяют десять unit-тестов. Полный SQL-код, данные, runner и тесты доступны в публичном проекте XNova на проверенном commit. Для воспроизведения нужен Python 3.12+ со стандартной библиотекой sqlite3; отдельный сервер не требуется. После обычного клонирования выполните:
git clone https://github.com/xnova-tech/sql-join-aggregation-example
cd sql-join-aggregation-example
git checkout 7072487857fbf856a7fb8deaf3f8f40bb6b75502
python -I examples/run.py
python -I examples/test_queries.py
python -I examples/check_suite.py
Основные строки ожидаемого отчёта:
order_id | wrong_cents | correct_cents | shipments
101 | 30000 | 15000 | 2
102 | 4000 | 4000 | 1
103 | 8000 | 8000 | 0
total: wrong=42000 correct=27000
order 101 fanout: joined_rows=6 items=3 shipments=2
order 101 SUM(DISTINCT line_amount)=5000
Последняя команда должна вывести 10 tests passed. Эти результаты относятся к заранее заданным синтетическим данным. Для настоящей витрины нужно расширить выборку реальными сочетаниями кратностей и определить источник бизнес-истины для сверки.
Что проверить перед следующим JOIN
В нашем случае JOIN умножил три позиции заказа 101 на две отгрузки. SUM честно сложил шесть получившихся строк: 300 рублей вместо 150. Общая стоимость позиций выросла с 270 до 420 рублей, хотя исходные товары и цены не менялись.
Чтобы найти и предотвратить такую ошибку в другом отчёте:
- Определите зерно результата: что представляет одна строка и какой ключ должен быть уникальным.
- Проверьте кратность источников по ключам соединения.
- Посмотрите фактические строки до
GROUP BY, а не только итоговыйSUM. - Считайте независимые агрегаты на нужном зерне до соединения; для проверки наличия связанной записи рассмотрите
EXISTS. - Сверьте итоги с расчётом по исходным фактам и добавьте отрицательные тесты на одну, несколько и ноль связанных строк.
В исправленном запросе стоимость заказа не зависит от числа его отгрузок, а shipment_count остаётся самостоятельной метрикой. Для отчёта о выручке понадобятся дополнительные бизнес-правила о платежах, скидках и возвратах: технически правильное соединение само по себе их не определяет.
Источники
- Устройство JOIN и промежуточная таблица перед GROUP BY
- Семантика SUM и COUNT для входных строк агрегации
- Порядок обработки FROM, JOIN, WHERE и GROUP BY в SQLite
- Поведение SUM, COUNT и DISTINCT внутри агрегатных функций SQLite
- Полный SQL-пример, тесты и CI на проверенном commit
- Публичный репозиторий примера для обычного git clone