
Вы спрашиваете у внутреннего помощника: «Что проверить, если API возвращает HTTP 503?» Где-то в документации команды уже есть инструкция: сначала открыть журнал ошибок, затем проверить доступность upstream. Но модель может не знать об этой инструкции — особенно если её недавно изменили.
Можно устроить иначе: прежде чем просить модель ответить, найти подходящую инструкцию и передать её текст вместе с вопросом. Так работает RAG (retrieval-augmented generation). Сам поиск ещё не гарантирует верного ответа, зато становится видно, откуда приложение взяло сведения.
Сначала разберём, как документы попадают в поиск и что происходит при вопросе. Потом запустим небольшой пример на Python: увидим выбранный документ d01, его источник и собранный контекст. Заодно проверим случай, когда поиск пропускает подходящую по смыслу инструкцию. Языковую модель в этом примере не запускаем — её ответы пришлось бы проверять отдельно.
Что такое RAG и какую задачу он решает
RAG объединяет поиск внешних материалов с генерацией ответа языковой моделью. Название расшифровывается как retrieval-augmented generation — генерация с дополнением найденной информацией. В работе Lewis и соавторов 2020 года предобученная модель сочетается с внешней памятью в виде индекса документов.
Представьте две части системы. В одной находятся знания модели, полученные при обучении. В другой — инструкции, справочники и другие документы, которыми управляет приложение. Когда команда меняет рабочую инструкцию, веса модели сами по себе не меняются. Зато документ можно обновить в корпусе, а затем найти при следующем запросе.
Допустим, вчера инструкция советовала проверить один сервис, а после изменения инфраструктуры — другой. Если поиск обращается к актуальному корпусу и выбирает нужный фрагмент, генератор получает новую рекомендацию без переобучения модели. Но здесь есть два отдельных риска: поиск может вернуть не тот документ, а модель — исказить содержание найденного.
Мы рассмотрим двухэтапный RAG: сначала приложение ищет фрагменты, затем один раз обращается к генератору. Бывают и агентные варианты, где модель решает, когда искать и повторять ли поиск. Оба подхода описаны в документации LangChain о Retrieval. Для знакомства начнём с последовательности, которую легко проследить по данным.
Архитектура RAG: два пути данных
Подготовка документов и обработка вопроса — два разных процесса: материалы собирают и подготавливают заранее, а нужные фрагменты выбирают при поступлении запроса. В документации Haystack эти части описываются как конвейеры индексации и обработки запроса.
При подготовке корпуса приложение читает документы из утверждённых источников, извлекает текст, при необходимости делит длинные документы на фрагменты (chunks) и сохраняет их в системе поиска. Вместе с текстом важно хранить id и источник: без них нельзя надёжно показать, какой именно фрагмент вернулся из поиска. Если документ обновился, соответствующие записи нужно обновить или переиндексировать; иначе поиск продолжит опираться на устаревшую версию.
При обработке вопроса поисковая часть получает текст запроса, выбирает несколько подходящих фрагментов, а приложение собирает из них контекст для модели. После этого генератор получает вопрос и контекст и может сформулировать ответ. Схематично маршрут выглядит так:
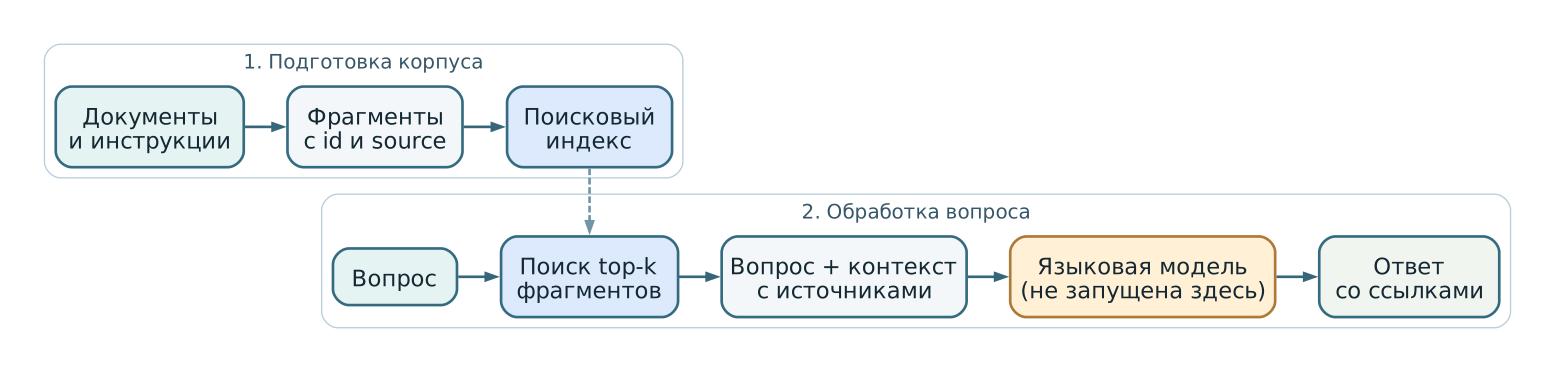
В реальной системе между этими блоками могут появиться фильтры по правам доступа, повторное ранжирование, лимит объёма контекста, журналирование и проверка ссылок. Они не меняют исходной идеи. Схема показывает, какие данные каждая стадия принимает и возвращает.
Важно различать текст источника и ссылку на источник. Имя файла, переданное вместе с фрагментом, помогает показать происхождение, но не гарантирует, что каждое утверждение будущего ответа действительно содержится в этом файле. Проверку подтверждения утверждений придётся строить отдельно.
Как RAG находит нужные документы
Поисковый компонент получает запрос и возвращает подходящие документы или фрагменты; текст ответа создаёт отдельный генератор. В обзоре Haystack это роли Retriever и Generator. Разделение полезно и при отладке: можно сначала посмотреть на выдачу поиска и лишь затем исследовать ответ модели.
Для начала подойдёт лексический поиск. Он выделяет слова из вопроса и фрагментов и оценивает пересечение. Для вопроса «Что делать при HTTP 503 у API?» документ со словами HTTP, 503 и API получает больший балл, чем инструкция про токен доступа. Такой способ прозрачен, но зависит от совпадения формулировок.
При семантическом поиске текст превращается в числовой вектор — embedding, — после чего система ищет близкие представления. Это может помочь, когда вопрос и документ описывают одно явление разными словами. Документация LangChain разбирает разбиение, эмбеддинги, векторные хранилища и извлечение фрагментов. Выбор подхода не освобождает от проверки качества: семантический поиск тоже может промахнуться.
| Способ | Что сопоставляется | Что нужно учитывать |
|---|---|---|
| Лексический | Совпадающие слова и токены | Синонимы, словоформы и разбиение текста |
| Семантический | Векторные представления запроса и фрагментов | Выбор модели эмбеддингов, обновление индекса, ложные совпадения |
После подсчёта оценки поиск обычно отдаёт первые k результатов — top-k. У каждого результата должны остаться id, источник и сам текст. В нашем учебном коде k=1, а при одинаковой оценке первым идёт меньший doc_id. Это делает результат повторяемым, но не превращает количество совпавших слов в меру истинной релевантности.
Для пяти коротких записей отдельная векторная база не нужна. Пример ниже просто перебирает документы в памяти. В архитектурной схеме индекс показан как типичный компонент полноразмерной системы; здесь его роль выполняет небольшой список записей.
Пример RAG на Python: находим документ и собираем контекст
Проверим поисковую часть на маленьком корпусе. В нём всего пять вымышленных инструкций: об ошибке API 503 (d01), подключении к базе данных (d02), токене доступа (d03), кэше (d04) и ограничении частоты запросов (d05). В файле documents.json у каждой записи есть три поля: id, source (например, runbooks/api-503.md) и text. Это учебные строки: реальных HTTP-запросов программа не делает.
Весь работающий пример — в закреплённом commit проекта XNova. Там находятся корпус, исходный код, десять тестов и CI для Linux, macOS и Windows. Ниже показаны функции, от которых зависит поиск; полный код и тесты доступны в том же проекте.
Как выбирается документ
Функция tokens приводит текст к одному регистру и выделяет множество слов. Знаки препинания не участвуют в сравнении: например, HTTP-503 распадается на http и 503. Для каждого документа retrieve считает количество общих слов с вопросом, отбрасывает нулевые совпадения и сортирует оставшиеся записи по убыванию оценки. Ниже точный фрагмент rag_context_demo.py:
def tokens(text: str) -> set[str]:
    """Выделить регистронезависимое множество Unicode-слов."""
    return set(re.findall(r"[^\W_]+", text.casefold()))


def retrieve(
    query: str,
    documents: Sequence[Document],
    k: int = 1,
) -> list[Document]:
    """Вернуть до k документов с ненулевым лексическим пересечением."""
    if k < 1:
        raise ValueError("k must be positive")

    validated = validate_documents(documents)
    query_tokens = tokens(query)
    scored = [(len(query_tokens & tokens(document["text"])), document) for document in validated]
    ranked = sorted(
        ((score, document) for score, document in scored if score > 0),
        key=lambda item: (-item[0], item[1]["id"]),
    )
    return [document for _, document in ranked[:k]]
Почему здесь есть validate_documents? JSON приходит как данные, а не как готовые типизированные объекты. Перед поиском программа проверяет, что записи содержат непустые id, source, text, и отклоняет повторяющиеся идентификаторы. Эти проверки находятся в полном файле проекта.
Параметр k ограничивает число найденных документов. В демонстрации k=1; если оценки равны, раньше идёт меньший id. Такой порядок делает пример воспроизводимым, но количество совпавших слов не измеряет смысловую близость. Вопрос «Шлюз временно недоступен» не содержит общих слов с нашей инструкцией про HTTP 503, поэтому поиск вернёт пустой список, хотя человек может увидеть связь.
Запуск и результат
Скачайте проект с исходниками, откройте его корневой каталог и используйте Python 3.12 (команды подготовки окружения есть в README). Затем выполните:
python -X utf8 -I rag_context_demo.pyДля приведённых документов получен такой результат:
question: Что делать при HTTP 503 у API?
selected: d01 (runbooks/api-503.md)
context:
[d01] runbooks/api-503.md
При HTTP 503 у API проверьте журнал ошибок и доступность upstream.
generator_called: false
В проверенном примере лексический поиск выбирает d01, а генератор не вызывается. Строка selected показывает найденную запись и источник, а блок context — текст, который приложение могло бы передать модели. Функция assemble_context лишь соединяет эти данные; она ничего не дописывает от себя.
Проверить результат полезнее, чем просто убедиться, что программа завершилась без ошибки. Например, тест ожидает именно d01 с путём runbooks/api-503.md, а отдельный тест проверяет пустую выдачу для перефразированного запроса. В закреплённом проекте можно выполнить:
python -m pip install -r requirements-dev.txt
python -m pytest -q
В проекте есть 10 тестов. Они проверяют также одинаковые оценки, неверную структуру JSON, повторный id, k=0, Unicode и сохранение источника. Способ запуска и обнаружение тестов описаны в документации pytest.
Если Python не находит rag_context_demo, проверьте, что вы запускаете тесты из корня скачанного проекта и рядом с tests/ лежит pytest.ini. Для Windows команда python -m pytest -q остаётся той же, если нужный Python активирован в окружении. Установку и активацию окружения для разных систем показывает README проекта.
Этот пример проверяет поиск и подготовку контекста, но не точность будущего ответа языковой модели.
Что получает языковая модель после поиска
Программа выбрала d01 и сохранила путь к источнику. В полной RAG-системе приложение добавило бы этот фрагмент к вопросу и отправило получившееся сообщение генератору. Например:
Вопрос: Что делать при HTTP 503 у API?

Контекст из документов:
[d01] runbooks/api-503.md
При HTTP 503 у API проверьте журнал ошибок и доступность upstream.

Сформулируйте ответ только по доступному контексту.
Если данных не хватает, сообщите об этом.
Это пример входного сообщения, а не результат вызова модели. Мы не получали сгенерированный ответ и не знаем, выполнит ли модель просьбу опираться только на контекст. Такой переход от найденных документов к генератору описан в документации LangChain.
Здесь хорошо видна разница между источником и доказательством. Инструкция предлагает проверить доступность upstream. Если генератор напишет «ошибка точно вызвана upstream», это уже вывод, которого в источнике нет. Поэтому в рабочей системе нужно отдельно сверять существенные утверждения с найденными фрагментами. Путь runbooks/api-503.md сам по себе такой проверки не выполняет.
Что делать, если поиск ничего не нашёл? В демонстрации assemble_context([]) возвращает пустую строку. Приложение может остановить генерацию и сообщить об отсутствии подтверждающих документов. Это поведение лучше задать и проверить в коде, а не надеяться, что одна инструкция в сообщении всегда удержит модель от догадок.
Где ломается RAG и что проверять
Неправильный ответ может появиться на любом участке. Поэтому разбирать проблему удобно по маршруту данных: сначала выяснить, что лежало в корпусе, затем что нашёл поиск и что дошло до генератора:
| Этап | Возможная ошибка | Наблюдаемая проверка |
|---|---|---|
| Корпус | Документ устарел или не попал в индекс | Проверить версию документа, id, источник и время обновления |
| Поиск | Релевантный фрагмент не найден | Сравнить запрос, выданные id и заранее размеченные подходящие документы |
| Контекст | Условие отрезано при разбиении или вытеснено ограничением длины | Просмотреть точный текст, отправленный генератору |
| Генерация | Ответ добавляет утверждение без опоры на фрагмент | Проверить каждое существенное утверждение по указанному источнику |
Наш тест «Шлюз временно недоступен» наглядно показывает ограничение лексического поиска: синонимы могут не пересекаться по словам с инструкцией об ошибке 503. Пустая выдача в этом случае доказывает лишь отсутствие совпадений по выбранному алгоритму. Она не доказывает, что подходящего знания в корпусе нет.
Найденный документ является данными, а не инструкцией для приложения или модели. Внешняя страница или файл могут содержать текст вида «игнорируй предыдущие правила». Если его бездумно перенести в запрос, возникает риск косвенной prompt injection. OWASP LLM01:2025 описывает этот механизм и прямо отмечает, что RAG не устраняет его полностью.
Поэтому источник нужно учитывать как недоверенный ввод: проверять разрешённые документы до поиска, ограничивать полномочия инструментов, отделять инструкции приложения от цитируемого текста и проверять критические действия вне модели. В нашем примере assemble_context только объединяет строки. Это не защита от подмены инструкций.
Для измерения качества поиска необходима независимая разметка релевантности и метрики для набора вопросов. Пять синтетических документов и десять проверок кода не заменяют такую оценку, равно как не измеряют задержку, стоимость или точность ответов настоящей LLM.
Когда RAG полезен и что ещё предстоит проверить
RAG пригодится, когда ответы должны учитывать документы, которые меняются независимо от модели: инструкции, техническую справку, регламенты или внутреннюю базу знаний. Приложение может найти фрагмент и передать его генератору, сохранив сведения об источнике. Насколько это поможет, зависит от свежести корпуса, качества поиска и проверки итогового ответа.
На пяти учебных документах мы дошли до конкретного результата: для вопроса об HTTP 503 поиск вернул d01, а приложение собрало контекст с текстом и путём к инструкции. Мы также увидели, почему совпадение слов пропускает перефразированный запрос. Оба случая можно повторить и проверить тестами.
Следующий шаг — подключить генератор и проверить уже ответ: не добавил ли он неподтверждённых причин ошибки, что делает при пустом поиске и как обрабатывает инструкции, попавшие в документы. До такой проверки у нас есть работающий поиск для RAG, но ещё нет подтверждённо работающей системы ответов.
Источники
- Исходная работа о RAG, сочетании параметрической и внешней памяти
- Независимые контуры индексации и обработки запроса, построение конвейеров
- Обязанности поискового компонента и генератора
- Компоненты поиска, разбиение текста, эмбеддинги и передача контекста генератору
- Риски косвенной prompt injection через внешние документы
- Стандартная библиотека Python: правила лексического разбиения строк
- Установка pytest, правила обнаружения тестов и запуск pytest
- Закреплённый commit воспроизводимого Python-примера, pytest-тестов и CI