
Допустим, у вас есть небольшая база инструкций по неполадкам. В одной заметке написано: «Если очередь фоновых задач растёт, проверьте число обработчиков и ошибки воркера». А инженер задаёт вопрос иначе: «Почему обработка фоновых заданий задерживается?»
Обычный поиск по совпадению слов может не связать эти две формулировки. Но человек понимает, что обе относятся к обработке задач. Именно на таком различии удобно разобраться, как работает векторный поиск.
Мы возьмём несколько вымышленных русскоязычных инструкций, превратим их в числовые векторы с помощью Python, сохраним в Qdrant и запросим ближайшие документы. В результате увидим не только оценку сходства, но и исходный текст с его источником — чтобы было что проверять.
Для опыта не нужны платная языковая модель и отдельный сервер Qdrant. При этом мы не будем считать первый найденный документ правильным только потому, что он оказался выше остальных: векторная близость помогает выбрать кандидатов, а их полезность ещё нужно оценить.
Что такое embeddings и почему текст можно сравнивать как векторы
Возьмём нашу инструкцию о растущей очереди. Python умеет сравнить её строки посимвольно, но сам по себе не знает, насколько она близка по смыслу к вопросу о задержке заданий. Для такого сравнения понадобится модель, которая превращает текст в числа.
Результат называют эмбеддингом (embedding). Модель получает предложение и возвращает вектор фиксированной длины. Для выбранной нами модели это 384 числа. Можно представить вектор как точку в пространстве из 384 измерений: координаты вычисляются по всему тексту, а не подписаны словами «воркер», «очередь» или «задержка».
Посмотрите на две фразы:
- «Очередь фоновых задач продолжает расти».
- «Обработчики не успевают выполнять задания».
Они говорят о близких ситуациях разными словами. Модель, обученная находить смысловые сходства, может расположить их векторы рядом. Но это свойство модели, а не правило русского языка: на незнакомой предметной области или двусмысленном вопросе она способна ошибиться.
Чтобы выбирать ближайшие векторы, нужна мера сходства. В примере используем косинусную близость (Cosine). Если представить векторы стрелками, она позволяет сравнивать направления стрелок. Для коллекции с метрикой Cosine Qdrant нормализует векторы при загрузке и может вычислять сходство через скалярное произведение. Это описано в документации коллекций Qdrant. Оценку сходства нельзя автоматически считать вероятностью правильного ответа.
Для русского языка возьмём sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2. В официальном каталоге FastEmbed указано, что модель многоязычная и возвращает плотный вектор (dense vector) из 384 чисел. «Плотный» означает, что каждая координата представлена числом; для первого примера не нужны разреженные векторы и гибридный поиск.
Есть одно принципиальное условие: документы и вопросы нужно преобразовывать согласованной моделью. Допустим, мы сохранили векторы заметок, а затем поменяли модель только для запросов. Даже если обе модели возвращают по 384 числа, координаты уже могут описывать разные пространства. Для новой модели векторы документов придётся пересчитать и заново проверить поиск.
Мы используем FastEmbed — библиотеку для вычисления эмбеддингов локально через ONNX Runtime. При первом запуске потребуется загрузить модель в кэш; само вычисление затем выполняется в Python, без платного API. В практическом руководстве FastEmbed разобран именно этот переход от текста к вектору.
Теперь у нас есть способ сравнивать предложения. Осталось сохранить векторы так, чтобы после поиска можно было вернуть человеку сами инструкции.
Что Qdrant хранит рядом с вектором
Представьте, что поиск вернул вам 384 числа, похожие на вектор вопроса. По этим числам нельзя понять, какую инструкцию нужно открыть. Поэтому векторная база данных должна сохранять связь между числовым представлением и исходной записью.
В Qdrant три основных понятия:
| Понятие | Роль в нашем примере |
|---|---|
| Коллекция (collection) | Набор записей с общей конфигурацией векторов, например runbooks |
| Точка (point) | Запись с идентификатором 101, вектором и дополнительными данными |
| Данные точки (payload) | source=runbooks/worker-queue.md и поле text с текстом инструкции |
Документация о коллекциях описывает параметры поиска, а документация о точках — идентификаторы, векторы и payload.
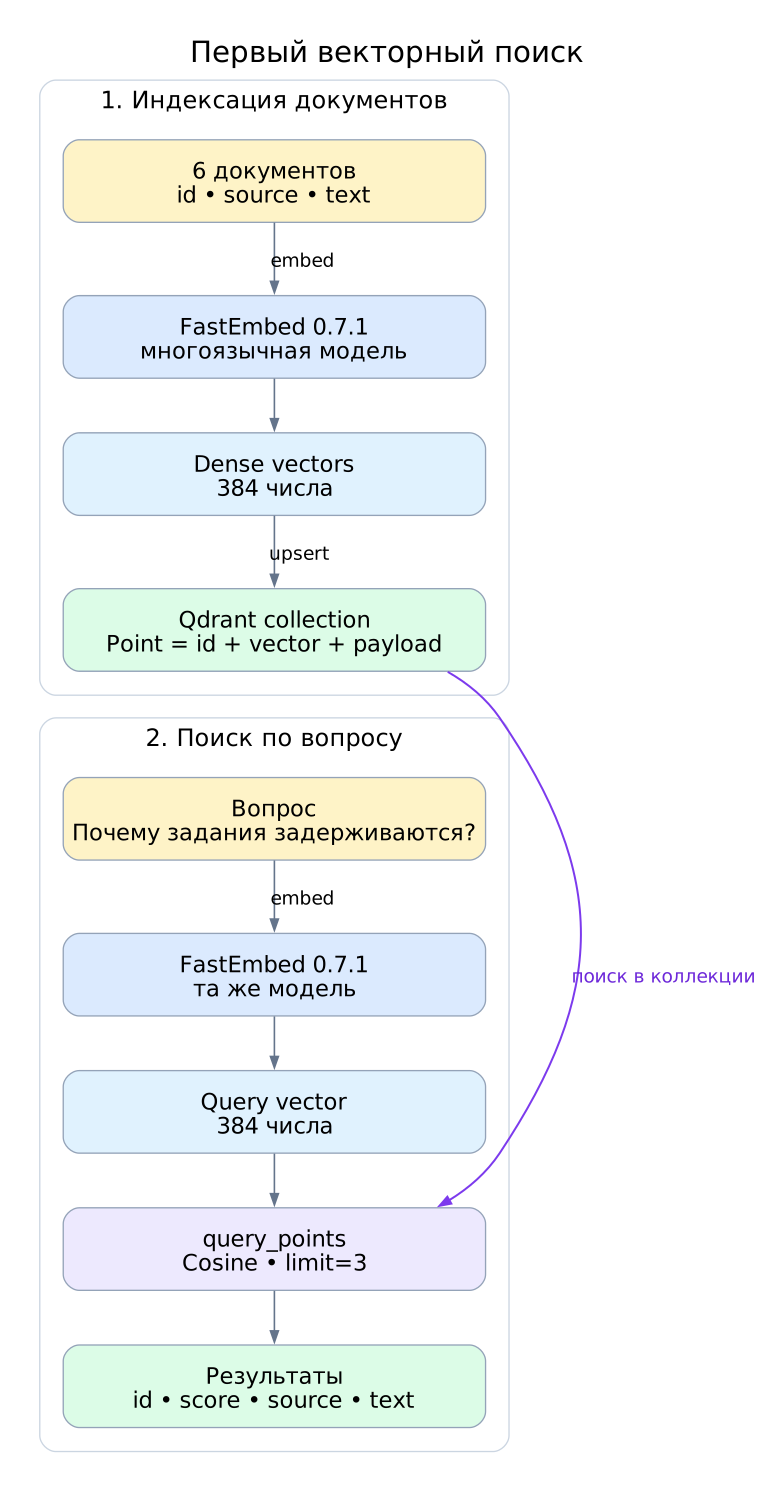
Посмотрите на верхнюю часть схемы: тексты инструкций проходят через FastEmbed и сохраняются в коллекции вместе с их id и payload. В нижней части вопрос проходит через ту же модель, после чего query_points ищет похожие векторы в коллекции. На выходе появляются идентификаторы, оценки близости и исходные тексты. Это два разных момента работы с одними и теми же данными: сначала подготовка документов, затем поиск при поступлении вопроса.
Коллекцию создают с конкретной схемой векторов: указывают размерность и метрику. В нашем случае это size=384 и distance=Cosine. Вектор из двух чисел сюда не подходит, даже если ему случайно соответствует очень похожий текст.
Особенно важен payload. Модель не знает, где лежит инструкция, и не создаёт поле source сама. Программа явно записывает рядом с вектором путь к заметке и её текст. Благодаря этому результат поиска можно прочитать, проверить и при необходимости связать с исходным документом.
Пока одна короткая заметка будет одной точкой. Для больших документов обычно приходится отдельно решать задачу разбиения на фрагменты, хранения версий и ограничения доступа. В первом опыте это усложнило бы главную мысль: вектор помогает найти кандидата, а id и payload возвращают ему человеческий смысл.
Готовим Python и запускаем Qdrant локально
Отдельный сервер пока не нужен. Python-клиент поддерживает QdrantClient(":memory:"): он создаёт хранилище внутри процесса, и данные исчезают после завершения программы. Это удобный способ проверить запись и поиск без Docker. Разработчики Qdrant рекомендуют такой режим для прототипов и тестов.
Этот режим удобен для маленьких примеров и тестов; он не проверяет сетевой сервер, его конфигурацию и производительность.
Сначала запустим самостоятельный скрипт с тремя инструкциями, затем разберём результаты проверенного проекта с шестью инструкциями и тестами. Значения score ниже получены на шести документах; у короткого скрипта они могут отличаться.
Для короткого примера создайте пустую папку и окружение Python 3.12:
mkdir qdrant-first-query
cd qdrant-first-query
python3.12 -m venv .venv
.venv/bin/python -m pip install "qdrant-client==1.15.1" "fastembed==0.7.1" "numpy==2.5.4" "onnxruntime==1.31.1"
На Windows используйте .venv\Scripts\python.exe вместо .venv/bin/python. На первом запуске понадобится сеть для установки библиотек и получения файлов модели. Позднее она сможет вычислять векторы из локального кэша.
Полный вариант доступен в публичном проекте XNova на проверенном commit. В проекте уже есть first_search.py, который обрабатывает шесть документов. Запускайте его из клонированного каталога, а короткий скрипт следующего раздела — из отдельной учебной папки. Команды для проекта приведены ближе к концу статьи.
Параметр local_files_only=True разрешает брать модель только из локального кэша. Если файлов модели там нет, их сначала понадобится скачать.
Если захотите сохранять данные между запусками, у клиента есть режим QdrantClient(path="local-qdrant"). Для сетевого сервера понадобится подключение по адресу. Эти варианты полезны позже, но не нужны, чтобы понять первый запрос.
Создаём коллекцию и записываем embeddings
Для первого запуска возьмём три короткие вымышленные инструкции: про очередь фоновых задач, ошибку API 503 и нехватку соединений PostgreSQL. Каждая имеет собственный id и путь source. Нам важно сохранить связь вектора с текстом, а не построить большой поисковый индекс.
Создайте файл first_search.py. Ниже самостоятельный минимальный пример: он вычисляет векторы настоящей многоязычной моделью, создаёт локальную коллекцию, записывает три точки и выполняет вопрос к ней. Значения score выводит сам запуск; ниже мы отдельно разберём результат расширенного варианта на шести документах.
from fastembed import TextEmbedding
from qdrant_client import QdrantClient, models

MODEL = "sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2"
COLLECTION = "runbooks"
NOTES = [
    (101, "runbooks/worker-queue.md", "Если очередь фоновых задач растёт, проверьте число обработчиков и ошибки воркера."),
    (102, "runbooks/api-503.md", "При HTTP 503 проверьте доступность upstream и журнал ошибок API."),
    (103, "runbooks/postgres-connections.md", "При нехватке соединений PostgreSQL проверьте размер пула и долгие транзакции."),
]
QUESTION = "Почему обработка фоновых заданий задерживается?"

model = TextEmbedding(model_name=MODEL)
text_vectors = list(model.embed([text for _, _, text in NOTES]))
query_vector = list(model.embed([QUESTION]))[0]
assert all(len(vector) == 384 for vector in [*text_vectors, query_vector])

client = QdrantClient(":memory:")
client.create_collection(
    collection_name=COLLECTION,
    vectors_config=models.VectorParams(size=384, distance=models.Distance.COSINE),
)
client.upsert(
    collection_name=COLLECTION,
    wait=True,
    points=[
        models.PointStruct(
            id=identifier,
            vector=vector.tolist(),
            payload={"source": source, "text": text},
        )
        for (identifier, source, text), vector in zip(NOTES, text_vectors, strict=True)
    ],
)

hits = client.query_points(
    collection_name=COLLECTION,
    query=query_vector.tolist(),
    limit=3,
    with_payload=True,
).points
for hit in hits:
    print(f"id={hit.id}, score={hit.score:.4f}, source={hit.payload['source']}")
    print(hit.payload["text"])
В первой половине скрипта TextEmbedding получает список текстов и возвращает векторы. Мы отдельно вычисляем представление вопроса: документные и поисковые векторы должны быть сопоставимы. Проверка len(vector) == 384 нужна для ясной ошибки при неожиданной размерности; в расширенной версии полезно также отвергать NaN, бесконечности и нулевые векторы.
Затем create_collection создаёт пространство поиска с косинусной мерой. PointStruct связывает целочисленный идентификатор, числовой вектор и payload. Запись через upsert создаёт точки или обновляет существующие с теми же id. По описанию записи точек Qdrant повторная операция с тем же идентификатором заменяет запись, поэтому полезно отдельно проверять количество точек после повторной загрузки.
Здесь одна заметка становится одной точкой. В рабочей системе длинный документ обычно режут на небольшие фрагменты и отдельно хранят идентификатор документа, версию и местоположение фрагмента. Разбиение текста улучшает управляемость контекстом, но вводить его до первого запроса не требуется.
Первый запрос через query_points
В конце скрипта модель вычисляет embedding для вопроса: «Почему обработка фоновых заданий задерживается?» Клиент получает уже готовый числовой вектор, поэтому query_points не должен догадываться, какую модель мы использовали.
hits = client.query_points(
    collection_name=COLLECTION,
    query=query_vector.tolist(),
    limit=3,
    with_payload=True,
).points
Здесь limit=3 означает «не более трёх ближайших точек», а with_payload=True просит вернуть связанные с ними исходные данные. Поле score — значение близости в выбранном векторном пространстве, id — идентификатор точки, source — путь к заметке. Синтаксис соответствует официальному quickstart Qdrant.
Сохраните код и выполните:
.venv/bin/python first_search.pyРасширенный пример с шестью заметками был выполнен в закреплённом Python 3.12.12 runner без сети. Получился такой результат:
documents: 6
embedding_dimensions: 384
stored_points_after_repeat: 6
query: Почему обработка фоновых заданий задерживается?
id=101 score=0.4641 source=runbooks/worker-queue.md
text=Если очередь фоновых задач растёт, проверьте число работающих обработчиков, ошибки воркера и время выполнения заданий.
id=105 score=0.3415 source=runbooks/redis-timeouts.md
text=При таймаутах Redis измерьте задержку сети и нагрузку на сервер кеша.
id=103 score=0.2408 source=runbooks/postgres-connections.md
text=При исчерпании соединений PostgreSQL проверьте размер пула и долгие транзакции.
В закреплённом Linux/arm64 runner результаты расположились в порядке 101, 105, 103 со значениями 0,4641, 0,3415, 0,2408. На другом процессоре последние знаки score могут немного измениться, поэтому переносимый тест проверяет порядок и небольшой числовой допуск, а точный вывод относится к указанному runner.
Как читать выдачу? Если первой оказалась инструкция про воркеры, откройте её текст и проверьте, отвечает ли она на вопрос. Если выше оказалась другая заметка, это повод исследовать ранжирование и корпус, а не объявлять её полезной только из-за более высокого балла. Высокий score измеряет сходство, но не подтверждает истинность или достаточность содержания.
В полном проекте first_search.py вызывает функции из модулей qdrant_example, отвечающих за чтение корпуса, настройки, FastEmbed и Qdrant. Pytest отдельно проверяет размерность, числовую корректность векторов, payload и количество точек после повторной записи. Исходные документы вымышлены: это тестовый корпус для механики поиска, а не настоящие эксплуатационные записи.
Как проверить поиск и что делать при ошибке
У поиска есть два разных результата. Первый — технический: удалось ли загрузить документы, записать точки и получить их обратно с правильными источниками? Второй — содержательный: нашлась ли инструкция, которая действительно поможет ответить на вопрос?
Для первого у нас есть проверенный проект. В его корпусе шесть вымышленных заметок: очередь воркеров, HTTP 503, соединения PostgreSQL, TLS-сертификаты, таймауты Redis и готовность Pod. Получите закреплённый исходный код, установите зависимости из requirements-dev.txt и из корня проекта запустите:
.venv/bin/python check_corpus.py
.venv/bin/python first_search.py
.venv/bin/python -m pytest -p no:cacheprovider -p no:terminal tests
Первая команда должна подтвердить шесть корректно описанных документов. Вторая печатает количество точек после повторной записи и три найденные инструкции. Третья возвращает код 0 при успешном выполнении тестов; опция -p no:terminal отключает обычный вывод pytest.
Все 19 pytest-сценариев прошли в том же контейнере без сети. Проверены как обычные случаи, так и ошибки: повторяющиеся идентификаторы и источники, пустой текст, неверная размерность, нулевые и нечисловые компоненты векторов, повторный upsert, возврат исходных данных через payload. Отдельный интеграционный сценарий использует настоящую модель и проверяет порядок результатов с числовым допуском. Сохранённый запуск подтверждает работу этого корпуса и кода, а не качество поиска по любым документам.
Вторая проверка начинается после успешного запуска. В нашем опыте первым оказался документ 101 об очереди фоновых задач. Это разумный кандидат для вопроса о задержке, и его текст можно проверить непосредственно. Но следующий вопрос может иметь другой смысл, а нужного ответа может вообще не быть в базе. query_points всё равно способна вернуть ближайшие точки. Поэтому порог score нельзя выбирать по одному удачному примеру и считать универсальным признаком правильности.
Если что-то пошло не так, проверяйте по порядку:
- Python не находит
fastembedилиqdrant_client. Убедитесь, что вы запускаете скрипт из созданного окружения и установили зависимости в него. - Модель не загружается. При первом запуске проверьте сеть, место и права на каталог кэша. Для offline-запуска модель нужно скачать заранее. Отсутствующий кэш нельзя подменять тестовым вектором, если вы проверяете реальный поиск.
- Размерность не равна 384. Проверьте имя модели и параметры коллекции. Укоротить вектор или дополнить нулями — не исправление.
- В результате нет
sourceилиtext. Сверьте payload приupsertи параметрwith_payload=Trueпри запросе. - Выдача не соответствует ожиданию. Прочитайте сами документы и сравните вопрос с найденными текстами. Увеличение
limitпокажет больше кандидатов, но не улучшит автоматически саму модель.
Повторный upsert сохранил в коллекции шесть точек, а не двенадцать. Это подтверждено запуском и отдельной проверкой, но не отвечает на вопросы о конкурентной записи или эксплуатации сетевого кластера.
В реальном приложении придётся учитывать обновление документов, права пользователей на источники, качество выбранной модели и запросы без подходящей информации. Здесь мы не измеряли скорость поиска, не сравнивали его с BM25 и не проверяли генерацию ответов языковой моделью.
Что мы получили и что проверять дальше
Начинали с простого вопроса о задержке фоновых заданий. В инструкции оказались другие слова, но после преобразования текста в векторы Qdrant смог выбрать связанную с вопросом заметку. В проверенном наборе из шести документов она оказалась первой: id=101, score=0.4641. Рядом с числом мы получили источник и текст, поэтому результат можно оценить по существу.
Теперь вы знаете роль каждого компонента: FastEmbed вычисляет вектор, Qdrant хранит точки с id и payload, а query_points ищет ближайшие векторы для нового вопроса. При этом модель для документов и вопросов должна быть согласована, а размерность коллекции — соответствовать вектору.
Первый удачный поиск ещё не доказывает качество системы. Следующий разумный шаг — собрать несколько настоящих вопросов с заранее размеченными полезными документами, посмотреть, где поиск ошибается, и только после этого решать, нужны ли другая модель, гибридный поиск или подключение генерации RAG.
Источники
- Реестр поддерживаемых FastEmbed dense-моделей, их размерность и лицензии
- Вычисление embeddings локально через FastEmbed и подключение к Qdrant
- Официальный пример коллекции, записи точек и query_points
- Обзор структуры коллекций, точек и метаданных Qdrant
- Размерность векторов, выбор Cosine, создание коллекции, нормализация
- Точки, payload и idempotent upsert
- Qdrant Python SDK: локальный режим в памяти, пример query_points
- Версии Python-клиента и изменения API для выбора закреплённого runtime
- Штатный запуск pytest-набора из командной строки
- Проверенный commit полного примера, pytest-набора и GitHub Actions